当前 AI 知识库市场已形成五条清晰的技术路线。本文梳理 14 款代表性产品,覆盖个人知识管理、团队协作、AI 记忆层、企业 RAG 框架及代码图谱五大领域,帮助读者按场景精准匹配工具。
一图速览:五条赛道与核心产品
| 赛道 | 核心诉求 | 代表产品 | 典型用户 |
|---|---|---|---|
| ① 个人 PKM | 本地优先、双向链接、长期知识沉淀 | Obsidian、Logseq、Roam Research、思源笔记 | 研究者、深度写作者 |
| ② 团队协作文档 | Wiki 化知识沉淀、与办公生态集成 | Notion、Confluence、语雀、SharePoint、腾讯乐享 | 企业团队 |
| ③ AI 记忆层 | Agent 跨会话状态保持、事实时序追踪 | Zep、Mem0、Letta、LangMem | AI 开发者 |
| ④ 企业 RAG 框架 | 文档向量化、问答检索、Agent 编排 | WeKnora、Yuxi、Dify、RAGFlow、QAnything | 技术团队 |
| ⑤ 图谱 RAG / 代码图谱 | 显式知识关系、代码库语义理解 | LightRAG、Cognee、Graphify | 开发者 |
前两条赛道解决"人如何记录与复用知识",后三条赛道解决"AI 如何存储与检索知识",技术范式截然不同。同赛道内比较才有实际意义。
一、个人 PKM 赛道:构建第二大脑
1.1 产品定位速查
| 产品 | 核心定位 | 许可协议 | GitHub Stars(约) |
|---|---|---|---|
| Obsidian | 本地 Markdown + 双向链接 + 插件市场,个人知识管理标杆 | 免费个人 / 商业授权,核心闭源 | — |
| Logseq | 开源大纲式双链笔记,隐私与技术可控性优先 | AGPL-3.0 | 高 |
| Roam Research | 每日笔记流 + 双向链接图谱,学术写作与深度思考工具 | 商业 SaaS | — |
| 思源笔记 | 本地块级编辑 + 可选云端同步,中文语境优化 | AGPL-3.0 | 中 |
1.2 能力对比矩阵
| 能力维度 | Obsidian | Logseq | Roam Research | 思源笔记 |
|---|---|---|---|---|
| 数据存储 | 纯本地 Markdown | 纯本地(Markdown/EDN) | 云端托管 | 本地 + 可选云服务 |
| 双向链接 / 关系图谱 | 极强 | 支持 | 开创性实现 | 支持 |
| 大纲编辑 / 块引用 | 插件扩展 | 原生大纲 | 原生支持 | 块级引用 |
| PDF 标注 | 插件实现 | 原生支持 | 较弱 | 原生支持 |
| 扩展生态 | 最繁荣 | 中等 | 较弱 | 中等 |
| 协作能力 | 弱(依赖第三方) | 弱 | 原生支持 | 原生支持 |
| 学习成本 | 中等(需配置) | 中等 | 较高(理念独特) | 低-中等 |
1.3 各产品适用边界
Obsidian 凭借数千款社区插件形成最完整的扩展体系,自由度无可比拟;核心代码闭源,协作功能薄弱,适合愿意投入时间打磨个人工作流的用户。
Logseq 以真正开源和本地优先赢得技术用户信赖,大纲思维与日志流设计独特;界面精致度与插件丰富度略逊于 Obsidian。
Roam Research 开创了双向链接与网络式笔记的方法论,对学术研究者和非线性写作者极具吸引力;年度订阅成本较高,且完全依赖云端。
思源笔记 在块编辑体验与中文支持上表现突出,本地与云端灵活切换;社区规模相对有限,第三方集成尚在成长。
赛道选择建议:重视数据主权与扩展性选 Obsidian 或 Logseq;追求思维网络与学术写作选 Roam;偏好中文原生体验与低配置成本选思源笔记。
二、团队协作与企业知识库赛道
2.1 主流产品概览
| 产品 | 生态归属 | 典型应用场景 | 私有化部署 |
|---|---|---|---|
| Notion | 海外独立 | 块编辑 + 数据库 + Wiki 一体化,中小团队 All-in-One | 弱(以 SaaS 为主) |
| Confluence | Atlassian | 中大型研发团队文档中心,与 Jira 深度集成 | Data Center 版本 |
| 语雀 | 阿里 | 国内技术团队知识仓库,结构化文档友好 | 支持 |
| SharePoint | Microsoft 365 | 大型企业与政企集团门户,权限体系完备 | 强(私有化成熟) |
| 腾讯乐享 / ima | 腾讯 | AI 知识库 + 学习平台,微信生态内容剪藏 | 支持 |
| 蓝凌 aiKM、ONES Wiki | 国产套件 | 大型组织知识管理,与研发或办公套件联动 | 私有化支持 |
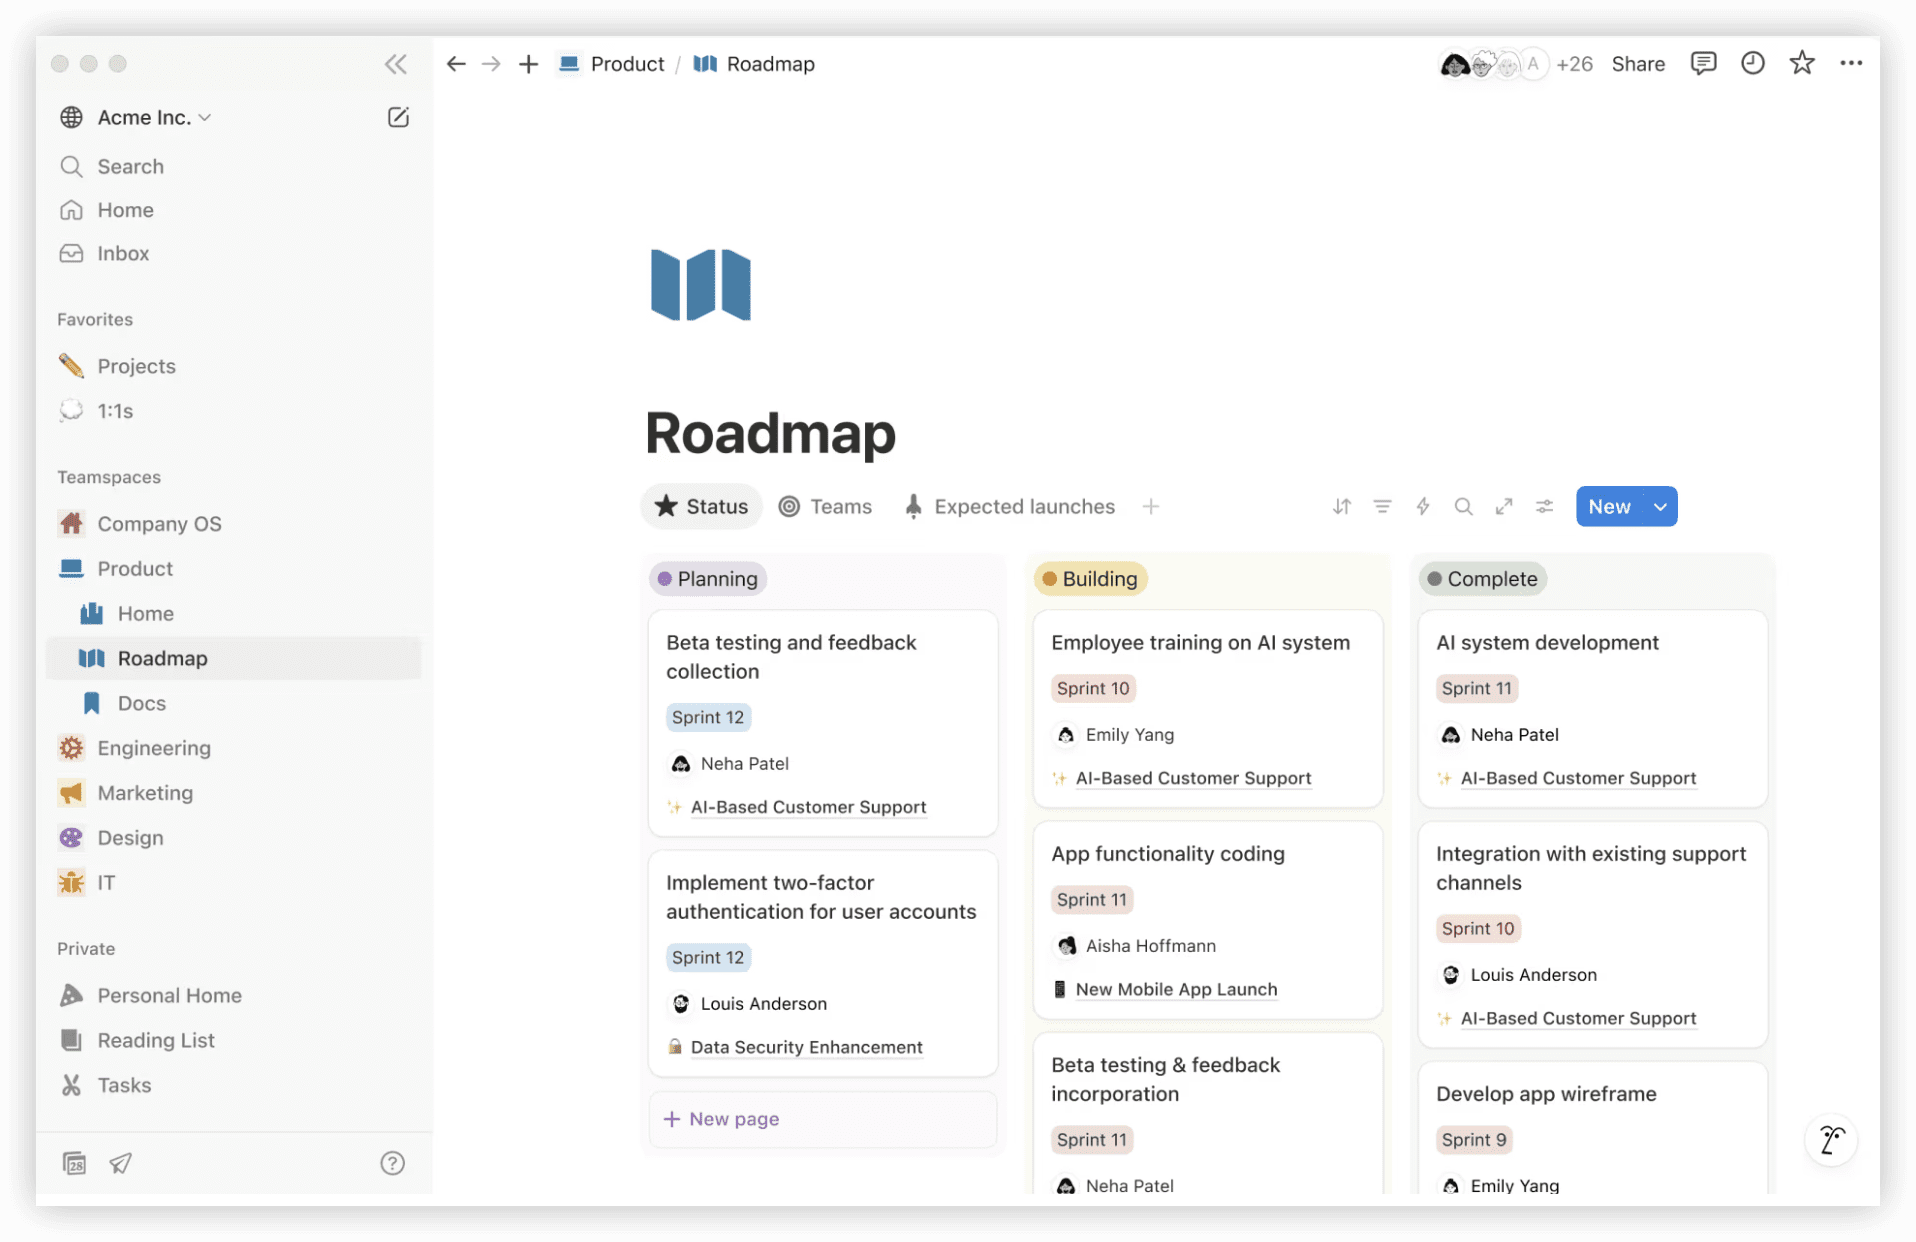
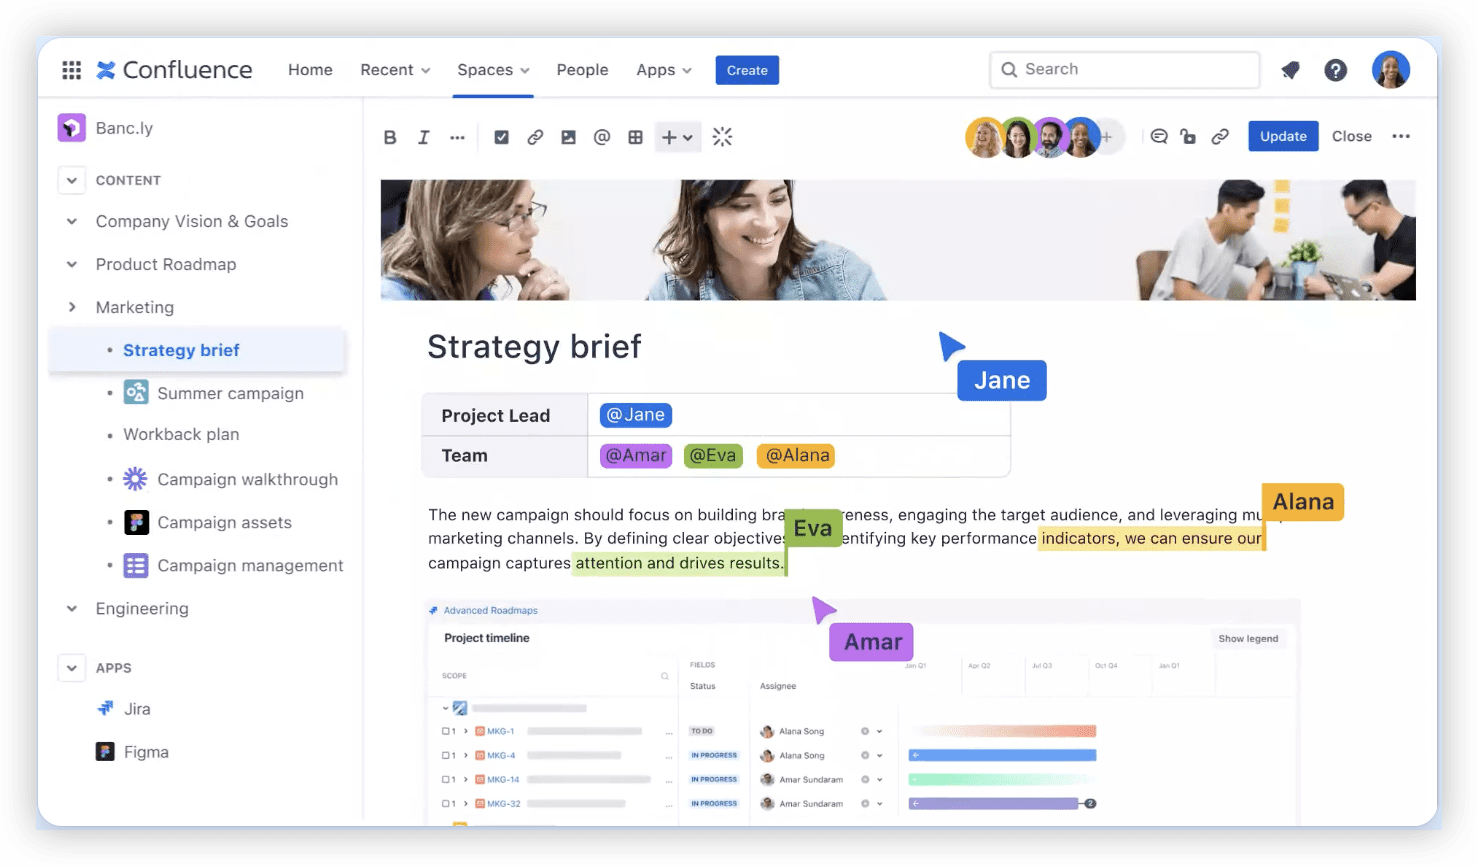
该赛道活跃产品逾二十款,选型的首要考量并非功能清单,而是与现有办公生态的绑定程度。已部署 Microsoft 365 的组织迁移至 SharePoint 成本最低,深度使用 Atlassian 工具链的团队自然延续 Confluence,强行跨生态整合往往得不偿失。
2.2 传统知识库与 AI 原生架构的融合趋势
传统协作文档的知识库功能以人工结构化 Wiki 为核心,AI 检索能力普遍薄弱。第三条至第五条赛道的产品则以 RAG、知识图谱、Agent 架构为原生设计。两类产品正在交汇——Notion AI、ima、腾讯乐享 AI 等功能陆续上线,但底层范式差异依然显著:前者是"文档协作增强 AI",后者是"检索推理引擎承载文档"。
三、AI 记忆层赛道:让 Agent 拥有持久记忆
该赛道解决大模型"跨会话失忆"的结构性难题。Zep、Mem0、Letta 构成第一梯队,LangMem 作为 LangChain 生态的原生方案占据特定场景。
3.1 产品定位
| 产品 | 一句话定位 | 开源协议 | Stars(约,2026-09) |
|---|---|---|---|
| Zep | 时序上下文图谱,处理事实随时间演变的复杂场景 | 商业 + 开源层 | — |
| Mem0 | 通用记忆层,三行代码接入,框架无绑定 | Apache-2.0 | 64K+ |
| Letta(原 MemGPT) | Agent 自主管理记忆块,记忆操作近似操作系统进程 | Apache-2.0 | 23K+ |
| LangMem | LangChain/LangGraph 原生记忆 SDK,支持程序级记忆改写 | 开源(LangChain 生态) | — |
3.2 核心能力硬对比
| 能力维度 | Zep | Mem0 | Letta | LangMem |
|---|---|---|---|---|
| 记忆分层架构 | 时序图谱 | 用户/会话/Agent 三级 | 核心/回忆/归档三级 | 语义/情景/程序三类 |
| 时序推理(事实有效期) | 最强 | 部分支持 | 不支持 | 不支持 |
| Agent 自主读写记忆 | 有限 | 提取与更新 | Agent 自编辑 | 含程序记忆改写 |
| 冲突消解机制 | 图谱合并 | 自动处理 | 自编辑策略 | 后台 Manager |
| 合规认证 | SOC2/HIPAA | SOC2/HIPAA/BYOK | — | 依赖部署方式 |
| 框架耦合度 | 中等 | 框架无关 | 运行时紧耦合 | 强绑 LangGraph |
| 托管服务 | 提供 | 提供 | Letta Cloud | 托管版本 |
| 自托管 | 部分 | 完整支持 | Docker 部署 | 完整支持 |
3.3 不可替代的差异化价值
Zep 在时序推理与企业合规两方面建立壁垒。用户偏好从 Adidas 迁移至 Nike 这类随时间变化的事实,Zep 能准确建模;SOC2/HIPAA 认证使其成为医疗、金融等监管敏感行业的默认选项。
Mem0 以接入效率取胜。三行代码完成集成,不受框架限制,支持语义、BM25、实体多路检索,托管与自托管双模式灵活切换。
Letta 赋予 Agent 最大的记忆自主权——自编辑记忆块、Sleep-Time Compute 离线整理、ADE 可视化调试。代价是学习曲线陡峭,内存自编辑可能破坏 prompt 缓存,Token 消耗显著高于竞品。
LangMem 是唯一支持 Agent 改写自身系统提示(程序记忆)的方案,与 LangGraph 深度集成。需注意:第三方基准测试显示其 p95 延迟达 59.82 秒,亚秒级响应场景建议转向 Mem0(0.2 秒)或 Zep。
选型红线:交互式 Agent 对延迟敏感,排除 LangMem,在 Mem0 与 Zep 之间权衡;需要 Agent 行为自主进化,考虑 Letta 或 LangMem;监管合规与时序事实为硬性要求,Zep 是唯一选择。
四、企业 RAG 框架赛道:文档到智能问答的工程化

4.1 产品定位
| 产品 | 核心定位 | 开源协议 | Stars(约) |
|---|---|---|---|
| WeKnora | 腾讯开源,三模式一体,快速上手 | MIT | — |
| Yuxi(语析) | 全栈智能体平台,知识库+图谱+Agent+沙盒,一体化程度最高 | MIT | — |
| Dify | 可视化 LLMOps + Agent 编排,社区生态最广 | Apache-2.0 衍生 | 154K+ |
| RAGFlow | 专注文档问答,复杂版式解析能力突出 | Apache-2.0 | 高 |
| QAnything | 网易有道自研,跨语言检索 + 全离线运行 | AGPL-3.0 | 中 |
4.2 功能矩阵
| 能力维度 | WeKnora | Yuxi | Dify | RAGFlow | QAnything |
|---|---|---|---|---|---|
| 知识库 RAG | 支持 | 支持 | 支持 | 支持 | 支持 |
| 知识图谱 | 支持 | 支持 | 插件扩展 | 元数据过滤 | 图检索 |
| 可视化工作流 | 中等 | 支持 | 强 | 画布式 | 较弱 |
| Agent 编排 | 中等 | 沙盒隔离 | 强 | v0.20+ 支持 | 不支持 |
| 文档解析 | 中等 | 中等 | 中等 | DeepDoc 最强 | 中文优化强 |
| 混合检索 + Rerank | 支持 | 支持 | 支持 | 三路并行 | 两阶段 |
| 代码执行沙盒 | 不支持 | 独有 | 插件 | v0.25 Agent 沙盒 | 不支持 |
| 私有化部署 | MIT 商用友好 | MIT 商用友好 | 支持 | 支持 | 全离线 |
| 上手难度 | 最低 | 高 | 低-中等 | 中等 | 中等 |
4.3 关键差异与取舍
WeKnora 以 MIT 协议和极简上手路径降低入门门槛,三模式一体设计适合快速验证"文档变问答"场景。
Yuxi 的沙盒隔离文件系统为五者独有——Agent 文件操作安全可控,artifacts 产物可交付,一体化程度最高但运维负担最重。
Dify 凭借 154K Stars、Apache-2.0 协议、Marketplace 插件市场及 SOC2 Type II + ISO 27001 企业认证,形成从原型到生产无需重构的完整链路。
RAGFlow 的 DeepDoc 引擎集成 OCR + TSR + DLR 三视觉模型,表格、多栏、图表的版式还原能力领先;v0.23 引入父子分块与图表上下文窗口,v0.25 新增 Agent 沙盒、用户级记忆隔离与发布灰度机制。
QAnything 实现真正的全离线运行(拔网线可用、纯 CPU、默认 ≥20GB RAM),BCEmbedding 在双语跨语言场景达到 SOTA。AGPL-3.0 强 Copyleft 协议对闭源商用构成限制,更适合内部工具或开源项目。
竞争格局:WeKnora 与 Yuxi 同属国产 MIT 开源路线,功能重叠度高,实际选型多为"二选一";Dify 与 RAGFlow 分别代表"编排广度"与"解析深度"的不同侧重;QAnything 因协议特性更适合特定合规场景。
五、图谱 RAG 与代码图谱细分赛道

| 产品 | 定位 | 关键特征 | 协议 |
|---|---|---|---|
| LightRAG | 图谱 RAG 框架 | 向量 + 图谱双路检索,配置简洁 | MIT |
| Cognee | 知识图谱构建引擎 | 语义 + 图谱 + 时序融合,图谱推理能力强 | 开源 |
| Graphify | 代码知识图谱 | 单命令将代码库转为可查询图谱,71.5 倍 Token 压缩,零向量库依赖 | MIT |
Graphify 是 2026 年增速最快的代码图谱工具(112K+ Stars),其核心设计值得单独说明:
- 本地优先架构,无遥测,基于 tree-sitter 确定性 AST 建图,全程零 LLM 调用
- 每条边标注 EXTRACTED / INFERRED / AMBIGUOUS 置信度,可解释性远超向量相似度
- 已与 Claude Code、Cursor、Codex、Copilot 等 20 余款 AI 编程助手集成
- 局限:专注代码库场景,非通用文档 RAG 方案
六、跨赛道综合速查
以下评分仅用于用户类型快速分流,不表示跨赛道的产品优劣。
| 产品 | 赛道 | 核心卖点 | 复杂度 | 协议/商用 |
|---|---|---|---|---|
| Obsidian | ① PKM | 插件生态最繁荣 | 中等 | 免费个人 |
| Logseq | ① PKM | 开源 + 本地大纲 | 中等 | AGPL-3.0 |
| Notion | ② 协作 | All-in-One 工作空间 | 低 | SaaS |
| Zep | ③ 记忆层 | 时序推理 + 企业合规 | 中等(需集成) | 商业 |
| Mem0 | ③ 记忆层 | 接入最快、框架无关 | 低 | Apache-2.0 |
| Letta | ③ 记忆层 | Agent 自主记忆管理 | 高 | Apache-2.0 |
| LangMem | ③ 记忆层 | 程序记忆 + LangGraph | 中高 | 开源 |
| WeKnora | ④ RAG | 上手最快 | 低 | MIT |
| Yuxi | ④ RAG | 沙盒 + 一体化 | 高 | MIT |
| Dify | ④ RAG | 生态最广、编排强 | 低-中等 | Apache-2.0 |
| RAGFlow | ④ RAG | 文档解析最强 | 中等 | Apache-2.0 |
| QAnything | ④ RAG | 跨语言 + 全离线 | 中等 | AGPL-3.0 |
| Graphify | ⑤ 代码图谱 | Token 压缩 71 倍 | 低 | MIT |
复杂度排序:Mem0 ≈ WeKnora ≈ Obsidian(最易上手) < Zep / Dify / RAGFlow(需开发集成) < Letta / Yuxi / LangMem(需技术团队运维)
七、选型决策框架
7.1 核心判断路径
问题 A:知识服务对象是"人"还是"AI"?
- 人 → 赛道 ①(Obsidian / Logseq / Roam / 思源)或赛道 ②(Notion / Confluence / 语雀等)
- AI → 继续问题 B
问题 B:AI 是否需要"跨会话记住用户偏好与事实变化"(有状态 Agent)?
- 是 → 赛道 ③
- 时序推理 + 合规(医疗/金融)→ Zep
- 最快接入、框架无关 → Mem0
- Agent 自主进化 + 可视化调试 → Letta
- 已在 LangChain/LangGraph 生态 → LangMem
- 否(将"文档"转为"问答/检索/推理")→ 赛道 ④⑤
- 快速搭建、验证优先 → WeKnora
- 可视化编排 + 生态插件 → Dify
- 复杂版式(PDF/表格/多栏)解析 → RAGFlow
- Agent 需安全操作文件(沙盒)→ Yuxi
- 跨语言 + 全离线 + 注意协议限制 → QAnything
- 代码库理解 / 极致 Token 效率 → Graphify
7.2 典型场景组合方案
| 场景 | 推荐组合 |
|---|---|
| 个人第二大脑 + 数据本地优先 | Obsidian / Logseq |
| 企业团队 Wiki + AI 问答增强 | Confluence / 语雀 + Dify / RAGFlow |
| 有状态 AI 客服/助手 | 赛道 ③:Mem0(通用)/ Zep(合规时序) |
| 文档问答 POC,速度优先 | WeKnora 或 Dify |
| 复杂 PDF/合同/报告 RAG | RAGFlow |
| Agent 执行操作 + 产出交付物 | Yuxi |
| 代码库 AI 辅助 + 成本控制 | Graphify |
| 国产大模型 + 私有化 + MIT 协议 | WeKnora / Yuxi(二选一) |
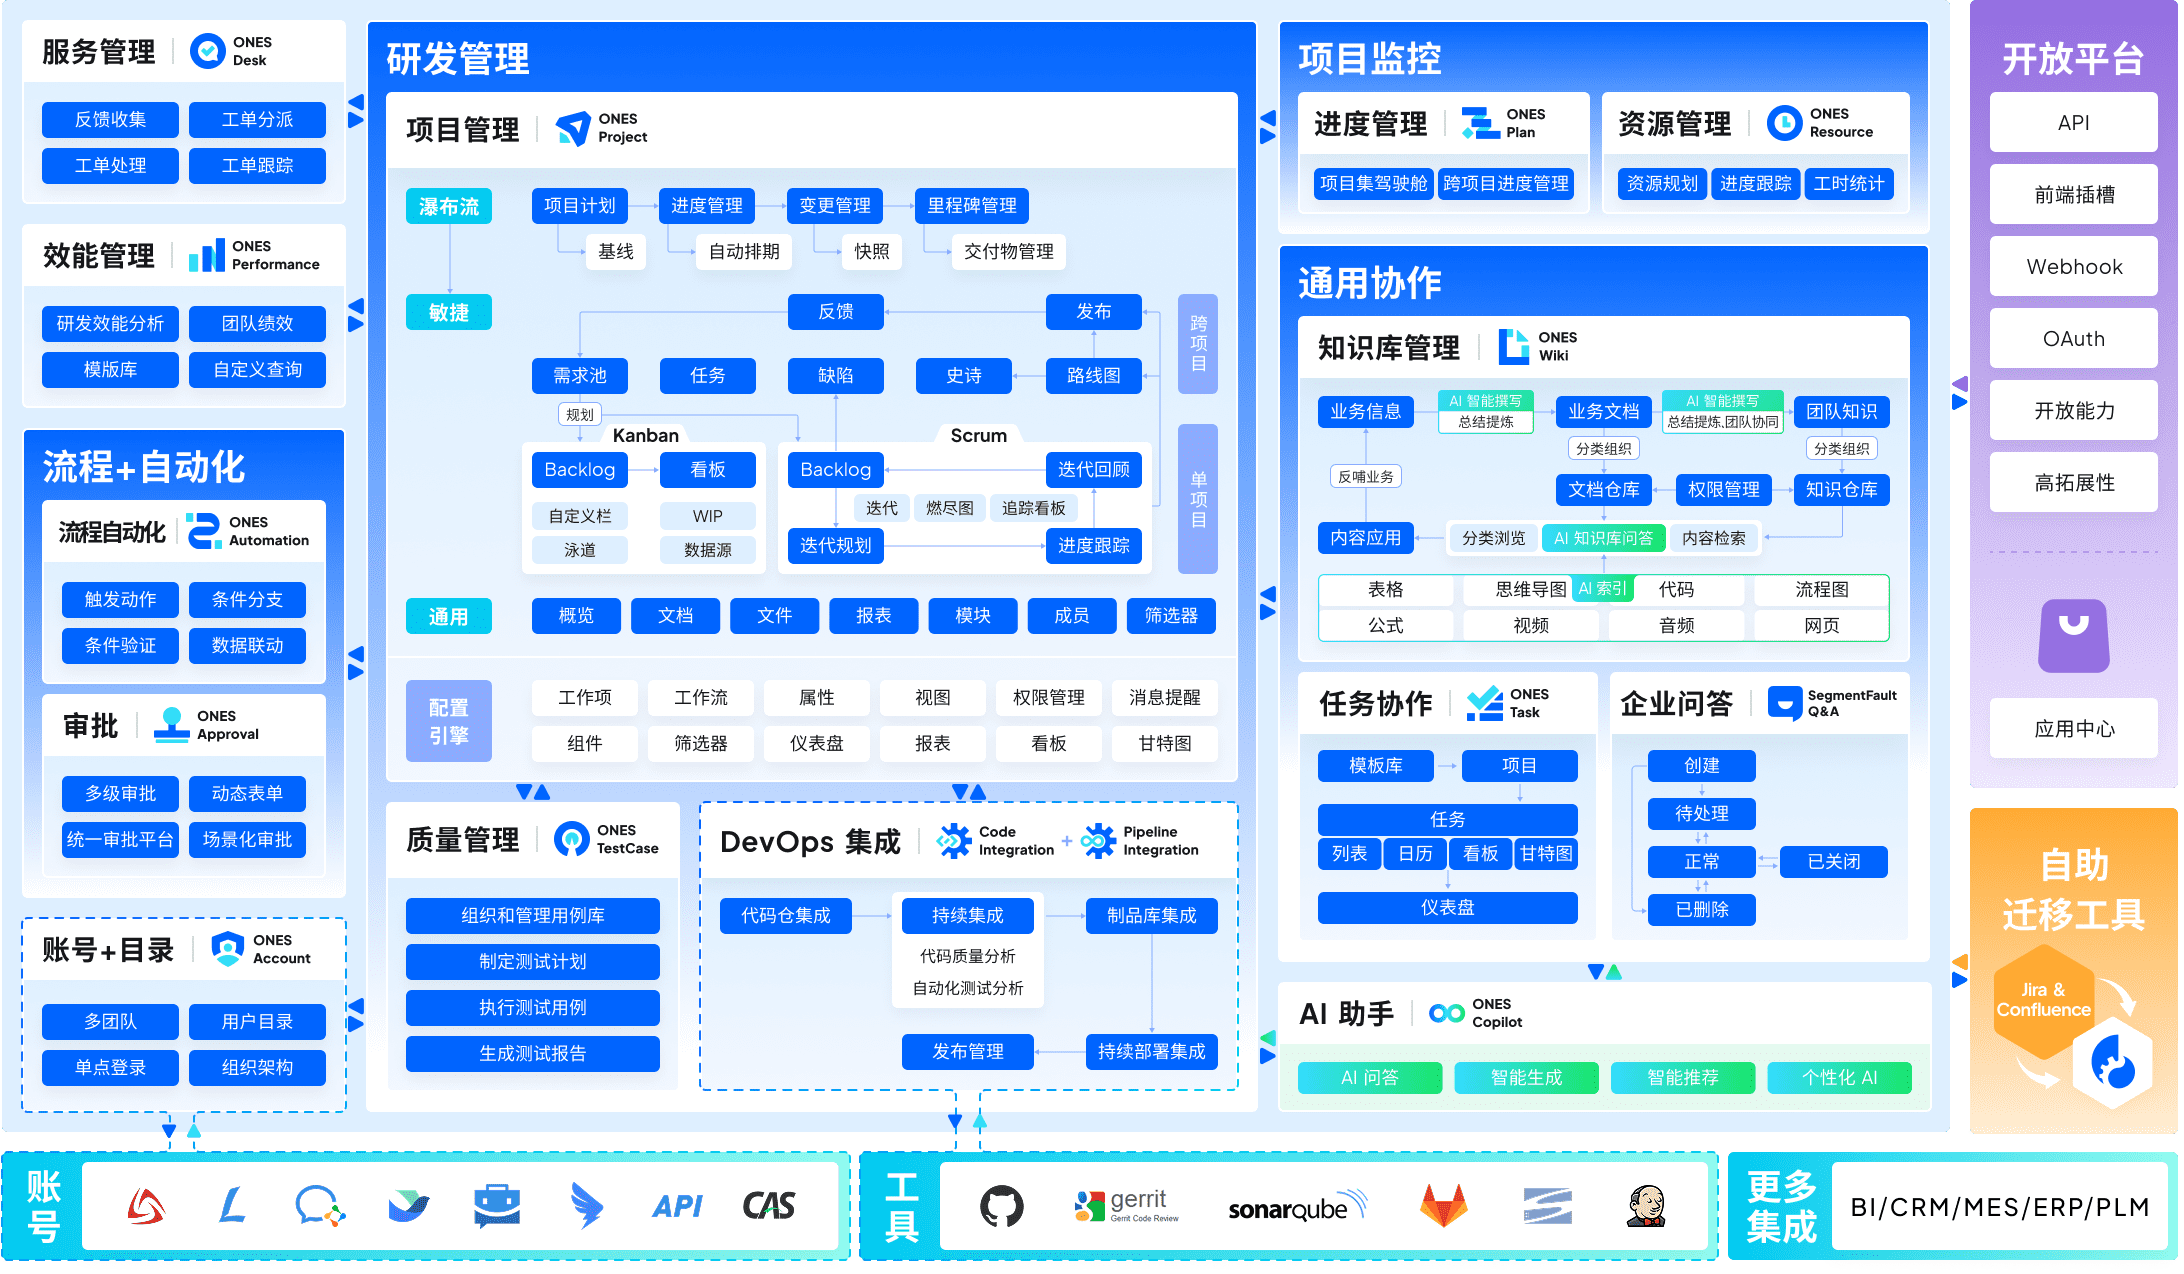
| 中大型研发团队全链路管理 | ONES(一体化覆盖项目管理、需求管理、知识库、测试管理、流水线与代码管理,支持复杂流程配置、权限模型与跨团队协作治理,以研发效能度量驱动交付质量与效率提升) |
八、风险与验证建议
8.1 许可协议风险
QAnything、Logseq、思源笔记采用 AGPL-3.0 强 Copyleft 协议,闭源商用需法务评估;WeKnora、Yuxi(MIT)、Mem0、Letta、Dify、RAGFlow、Graphify(Apache-2.0/MIT)商用限制较少。
8.2 赛道错配风险
将 RAG 框架当作个人笔记工具、或将记忆层产品用于文档问答,均会导致投入产出失衡。先明确赛道归属,再进入具体产品比较。
8.3 动态指标与验证方法
Stars、版本迭代、定价策略变化频繁,以各项目官方仓库为准(本报告数据截至 2026-09)。对于 WeKnora 与 Yuxi、Mem0 与 Zep 等"赛道内二选一"的纠结场景,建议以同数据集运行 POC,实测 RAG 准确率、响应延迟与 Token 成本三项核心指标。
九、结论
赛道 ① 个人 PKM:Obsidian 生态最完整,Logseq 开源替代最优。
赛道 ③ AI 记忆层:Mem0(速度)与 Zep(时序+合规)与 Letta(自主)与 LangMem(LangChain 生态)——四选一取决于技术栈与延迟约束。
赛道 ④ 企业 RAG:WeKnora 与 Yuxi 为国产 MIT 路线二选一;Dify 胜在广度,RAGFlow 胜在解析深度,QAnything 胜在全离线(需关注协议)。
赛道 ⑤ 代码图谱:Graphify 以 71 倍 Token 压缩和零向量库设计独树一帜。
核心选型逻辑:人的知识 → PKM 工具;AI 的记忆状态 → 记忆层;AI 读文档 → RAG 框架;AI 理解代码 → 代码图谱。本文提供赛道级全景,具体落地仍建议以小范围 POC 验证后再扩大投入。
常见问题(FAQ)
Q1:个人用户是否需要关注 RAG 框架?
通常不需要。个人知识管理优先选择赛道 ① 产品,RAG 框架的学习与运维成本对个人场景属于过度工程。
Q2:企业已有 Confluence,是否需要替换为 RAG 框架?
无需替换,建议叠加。Confluence 承担结构化文档协作,RAG 框架(如 Dify、RAGFlow)接入其内容源提供 AI 问答能力,形成互补。
Q3:Mem0 与 Zep 的核心差异是什么?
Mem0 追求接入效率与框架无关性,适合快速集成通用场景;Zep 专注时序事实建模与企业合规认证,适合金融、医疗等监管敏感领域。
Q4:AGPL-3.0 协议对商用具体有何影响?
AGPL-3.0 要求网络服务的使用者也能获取源代码,闭源产品将其作为核心依赖可能触发协议传染。建议法务评估后再用于商业场景。
Q5:如何评估 RAG 框架的文档解析能力?
准备包含表格、多栏排版、图文混排的复杂 PDF 作为测试集,对比检索结果的版式还原度、表格数据准确性、以及跨页上下文连贯性三项指标。