2026年,测试管理软件的AI能力已从概念验证走向实际落地。本文梳理了7款主流测试管理工具,涵盖从用例生成到结果分析的全流程AI辅助能力,帮助团队找到适合自身阶段的选型方案。
一、从手工测试到AI辅助:五个关键环节的变化
AI对测试管理的渗透并非均匀分布,而是集中在五个核心环节。理解这些环节的变化,是选型的基础。
| 环节 | 手工模式 | AI辅助模式 |
|---|---|---|
| 用例编写 | 基于需求文档逐条手工撰写 | 解析需求自动生成结构化草稿 |
| 脚本转化 | 手动编码或复制粘贴 | 自然语言用例自动转为可执行脚本 |
| 缺陷管理 | 手工录入、更新、关闭,关联关系人工维护 | 自然语言指令驱动数据查询与状态流转 |
| 覆盖率追踪 | Excel矩阵维护,需求变更时手工调整 | 自动识别覆盖缺口,标记需求变更影响范围 |
| 结果分析 | 人工统计Bug数量,主观判断优先级 | 检测不稳定测试,基于风险与影响智能排序 |
二、选型核心维度详解
1. AI生成用例
AI解析需求文档,输出包含前置条件、操作步骤、预期结果的结构化用例草稿。测试人员承担审核与微调角色,而非从零开始撰写。该环节对需求文档质量有一定要求,文档结构清晰时效果更稳定。
2. AI转化脚本
将已确认的测试用例自动转换为Selenium、Playwright等主流自动化框架的可执行代码。减少测试人员在不同工具间切换的成本,但复杂业务逻辑的脚本仍需人工介入优化。
3. AI管理缺陷
通过CLI或Skills接口,AI根据自然语言指令完成缺陷的查询、创建、更新与关闭操作,并自动维护需求、用例与缺陷之间的追溯关系。降低测试人员在工具操作上投入的碎片化时间。
4. AI辅助覆盖率追踪
需求变更时,AI自动识别受影响的用例集合,标记覆盖缺口,提示需要补充或调整的内容。替代传统Excel矩阵的手工维护模式,减少遗漏风险。
5. AI辅助结果分析
涵盖两个层面:一是识别不稳定测试(Flaky Test),提供根因分析建议;二是基于执行历史、代码变更影响面、业务风险权重等维度,对测试优先级进行动态排序,优化有限测试资源的分配效率。
三、7款主流测试管理软件横向对比
以下按AI覆盖维度数量将工具分为三个梯队,便于团队根据实际需求广度快速定位。
第一梯队:全流程覆盖型(4-5个维度)
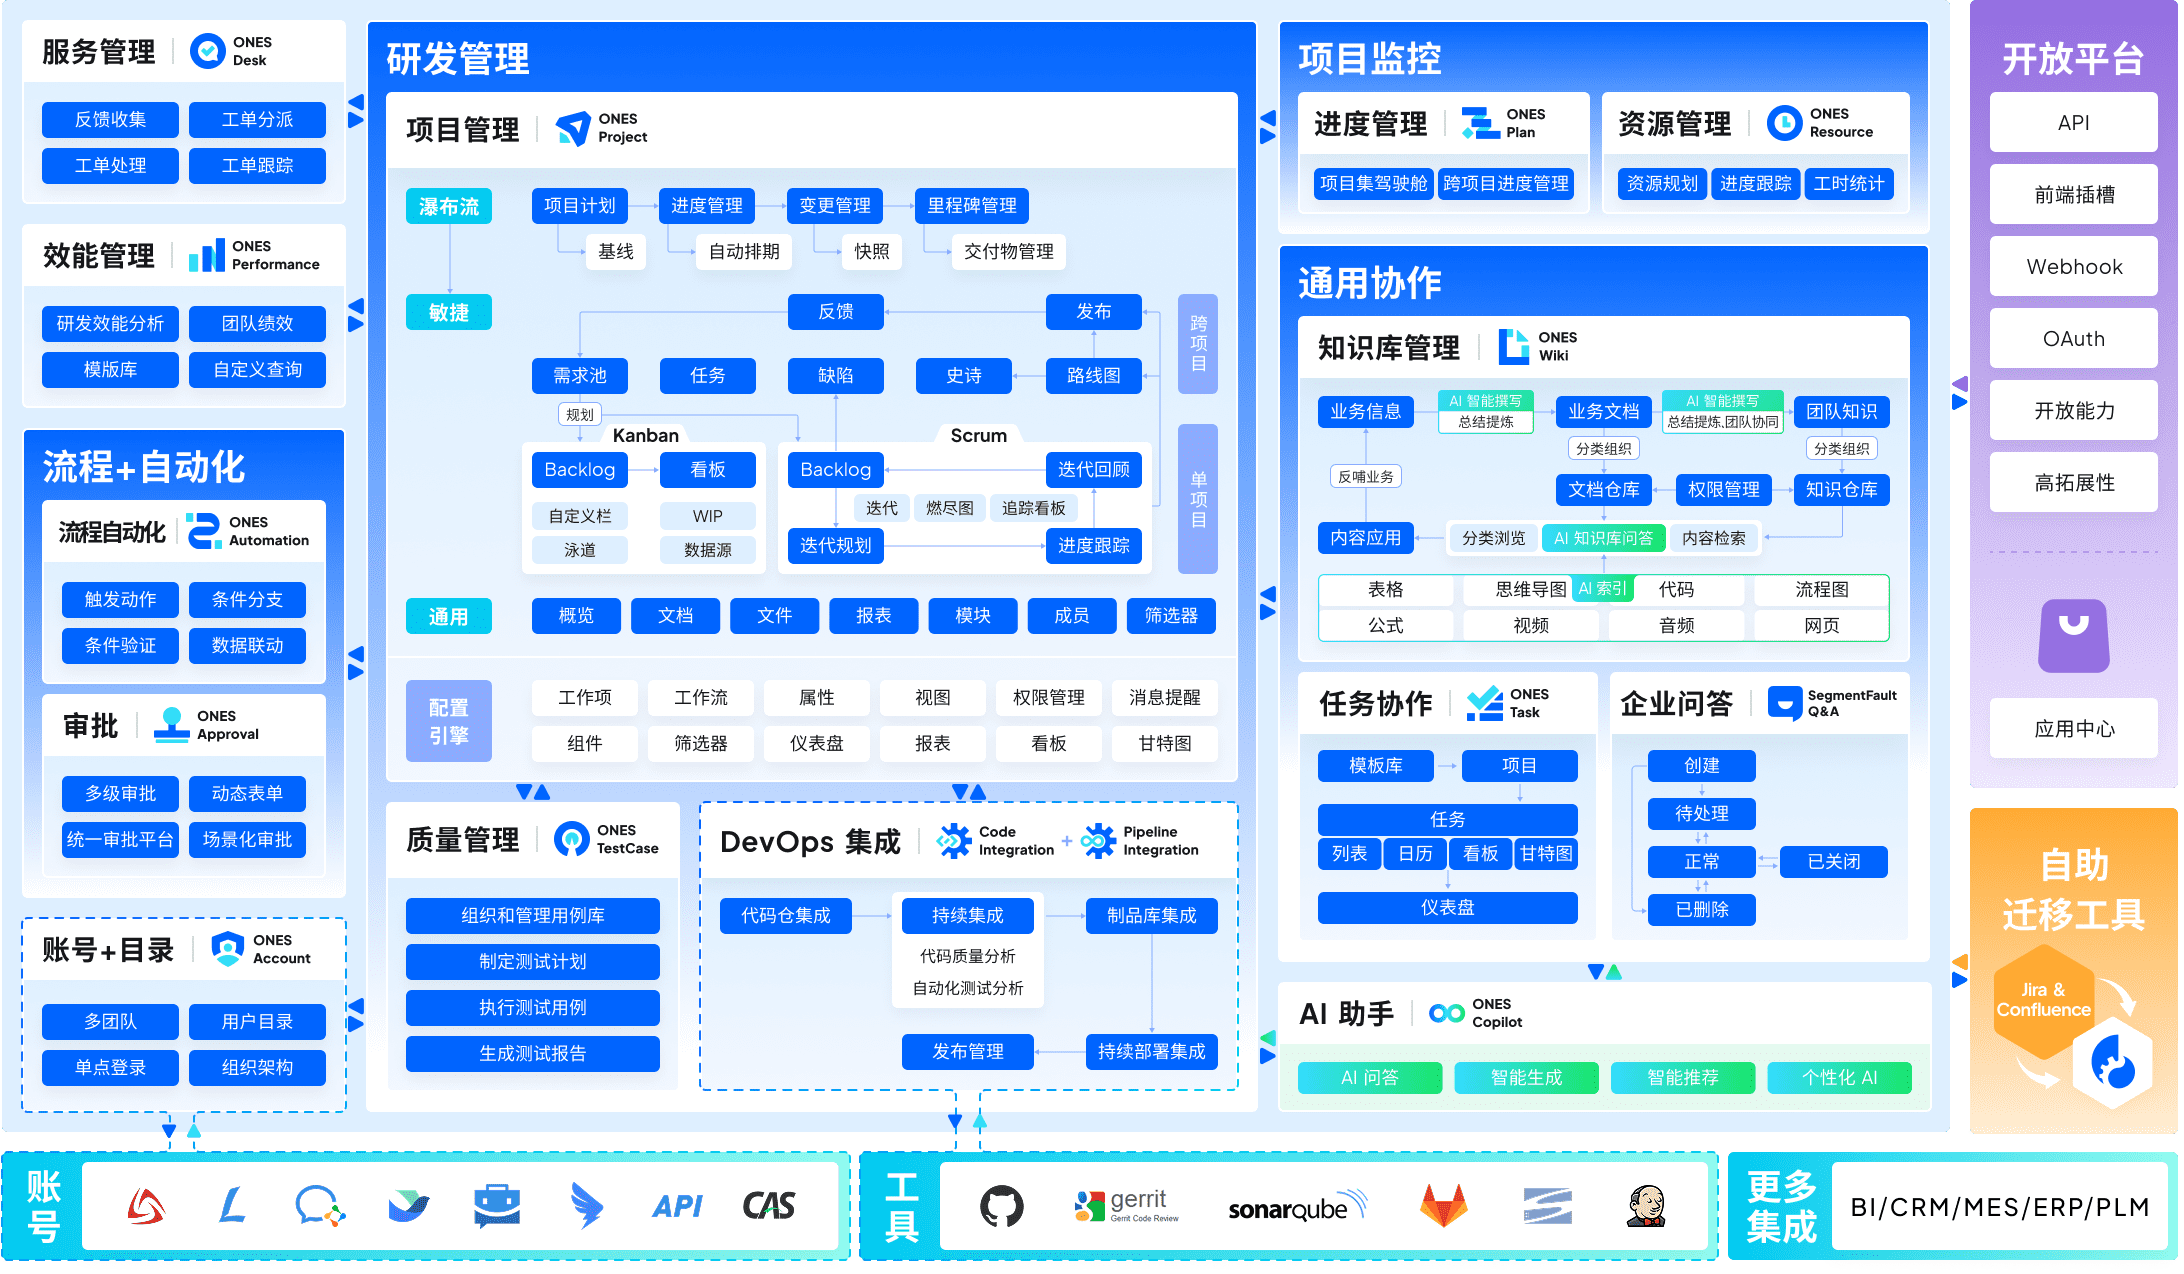
企业级研发管理平台,测试管理作为其核心模块之一,与项目管理、需求管理、知识库、流水线、代码管理形成一体化闭环。AI能力覆盖用例生成、脚本转化、缺陷管理、覆盖率追踪、结果分析五个维度。面向中大型组织,支持复杂流程配置、细粒度权限模型与跨团队协作治理,强调以研发效能度量驱动持续改进。适合测试体量大、流程完整、需要数据贯通与组织级质量治理的团队。
Xray
深度集成Jira的测试管理插件,AI覆盖Gherkin场景生成、Selenium/Playwright脚本转化、覆盖缺口检查、结果分析与优先级排序四个维度。依托Atlassian生态,适合已使用Jira且希望测试与需求、缺陷数据在同一平台流转的团队。

第二梯队:特定环节覆盖型(3个维度)
TestRail
独立测试管理平台,专注QA领域。AI覆盖用例生成、脚本转化、结果分析三个维度,其优先级排序融合机器学习与语义分析,可基于执行历史自动评分。适合需要独立QA平台、对测试数据隔离性有要求的团队。

PractiTest
以端到端追溯与需求覆盖见长的独立平台,支持MCP协议。AI覆盖用例生成、缺陷管理、覆盖率追踪三个维度。适合QA流程复杂、对审计追溯与合规要求较高的团队。

Testomat.io
统一管理平台,兼顾手工与自动化测试场景。AI覆盖用例生成、缺陷管理(MCP增删改查)、结果分析(不稳定测试检测)三个维度。适合自动化转型中期、两类测试并存的团队。
第三梯队:精准场景覆盖型(1-2个维度)
Qase
轻量级独立测试管理平台,AI目前聚焦脚本转化单一维度。提供丰富的API接口与报告能力,适合测试规模较小、追求快速上手与灵活集成的团队。
qTest
Tricentis旗下企业级平台,AI覆盖用例生成与缺陷分析管理两个维度,新增API的aiGeneratedSource字段用于标识AI生成内容来源。适合大型企业、多测试团队协同或组织级质量治理场景。

四、团队定位速查矩阵
| 团队规模/核心痛点 | 侧重方向 | 参考选项 |
|---|---|---|
| 中大型组织,需研发全流程贯通 | 一体化平台,数据驱动治理 | ONES |
| 已用Jira,求测试深度集成 | 生态内扩展,降低切换成本 | Xray |
| 独立QA部门,数据隔离优先 | 专业测试平台,独立权限体系 | TestRail、PractiTest |
| 自动化转型中,两类测试并行 | 统一管理,渐进过渡 | Testomat.io |
| 测试规模小,追求轻量快速 | 低门槛上手,灵活API扩展 | Qase |
| 多团队协同,组织级治理 | 企业级架构,合规与追溯 | qTest、ONES |
五、常见选型误区
1. 低估实施成本
工具上线存在客观的适应周期:流程需按新工具逻辑重新梳理,团队需从旧习惯迁移。选型时应将实施周期、培训投入、流程适配难度纳入总成本评估,而非仅对比功能清单。
2. 迷信演示环境
演示场景中AI表现往往基于理想化数据。真实项目中需求文档质量参差、历史数据混乱,AI输出质量会显著下降。建议用实际项目数据做PoC验证,再评估投入产出比。
3. 忽视数据迁移风险
不同工具的用例字段、关联关系、执行记录模型差异显著。迁移失败多源于字段不兼容或关联丢失。选型前需评估历史数据量、字段映射复杂度及官方迁移工具的成熟度。
4. 重AI轻基础
部分团队过度关注AI辅助功能,忽视测试管理的基础能力:用例版本管理、执行跟踪粒度、需求-用例-缺陷追溯链完整性等。基础能力薄弱时,AI功能难以发挥预期价值。
结语
AI对测试管理的价值,不在于替代人工,而在于将智能能力嵌入既有工作流,减少重复性劳动,释放测试人员的判断力与创造力。选型决策的核心,是识别团队当前的数据基础与痛点优先级,再匹配工具的覆盖维度与组织规模。功能清单的对照只是起点,工具与工作流的契合深度、团队的真实采纳程度,才是衡量选型成败的标尺。