研发团队知识库选型,本质上是一个从”凑合用”到”认真管”的演进命题。团队规模扩大后,文档散落在即时通讯、个人笔记、代码仓库等多个角落,检索效率急剧下降;而大模型技术的成熟,又让”文档能否被 AI 直接理解和回答”成为新的考量维度。本文基于实际迁移经验,梳理 8 款值得深入评估的工具,覆盖传统文档协作与 AI 原生知识库两类形态,并针对私有部署场景整理关键工程决策点。
8 款工具速览
- ONES — 企业级研发管理平台,一体化覆盖知识库与研发全链路
- Confluence — 成熟企业知识库,权限体系完善
- Notion — 灵活通用文档平台,适合泛内容管理
- Outline — 开源轻量 Wiki,开发者体验优异
- Wiki.js — 现代化轻量 Wiki,部署门槛低
- BookStack — 图书化知识组织,适合规范型文档
- Docusaurus — 静态站点生成器,工程化文档首选
- Dify — LLM 应用开发平台,RAG 能力完整
研发团队知识库的特殊性
通用文档工具强调的协同编辑与精美排版,在研发场景中往往并非决定性因素。研发团队的知识沉淀具有鲜明的内容特征:
四类核心内容形态
- 接口与 API 文档:要求与代码版本对应,支持 OpenAPI 等格式自动生成
- 架构设计与故障复盘:长文为主,依赖 Markdown 与代码块,需快速定位关键结论
- 操作手册与指南:强调可搜索性与步骤可用性,常需配图或视频
- 研发规范与清单:长期维护,对权限控制有严格要求
选型时若仅关注”能否写文档”,忽视上述差异,极易导致代码块支持薄弱、搜索质量低下等实际问题。
私有部署的现实动因
研发团队对私有部署的需求通常源于三方面:与内部系统深度集成的必要性、数据合规的硬性约束、以及对接现有 SSO/LDAP/CI/CD 体系的可行性。但私有部署伴随运维成本,需理性评估:15 人以下团队若无合规强需求,优先选择托管服务更为务实。
三个前置判断问题
- 主要写作者是全体工程师,还是少数专职人员?
- 内容偏向结构化技术文档,还是流程性说明文章?
- 短期内是否需要 AI 问答能力,还是仅需高效检索?
这三个问题的答案,直接决定工具类型的选择方向。
工具分组对比
传统文档协作类
| 工具 | 部署模式 | 核心定位 | 研发适配度 | 检索与 AI | 成本模式 |
|---|---|---|---|---|---|
| ONES | 云/SaaS 或私有化 | 企业级研发管理一体化平台 | 极强,原生适配研发流程 | 内置智能搜索,可扩展 AI 能力 | 订阅制,私有化按需报价 |
| Confluence | 云/SaaS 或 Data Center | 企业项目协作与知识库 | 强,管理功能偏重 | 搜索一般,AI 需额外配置 | 按用户订阅,自建需授权 |
| Notion | 云/SaaS 为主 | 通用笔记与文档协同 | 中等,工程师偏好分化 | 搜索尚可,AI 内置但依赖云 | 按用户订阅,无官方自建 |
| Outline | 自建为主 | 团队内部维基 | 很强,开发者友好 | 全文搜索可用,可接 AI 插件 | 开源核心,自托管免费 |
| Wiki.js | 自建 | 轻量 Wiki 系统 | 较强,界面现代 | 全文搜索尚可,无原生 AI | 开源免费 |
| BookStack | 自建 | 图书化组织 Wiki | 中等,适合规范型团队 | 全文搜索可用,无原生 AI | 开源免费 |
| Docusaurus | 静态站点生成 | 项目文档站 | 极强,工程化流程匹配 | 可通过 Algolia 实现全文搜索 | 开源免费 |
ONES
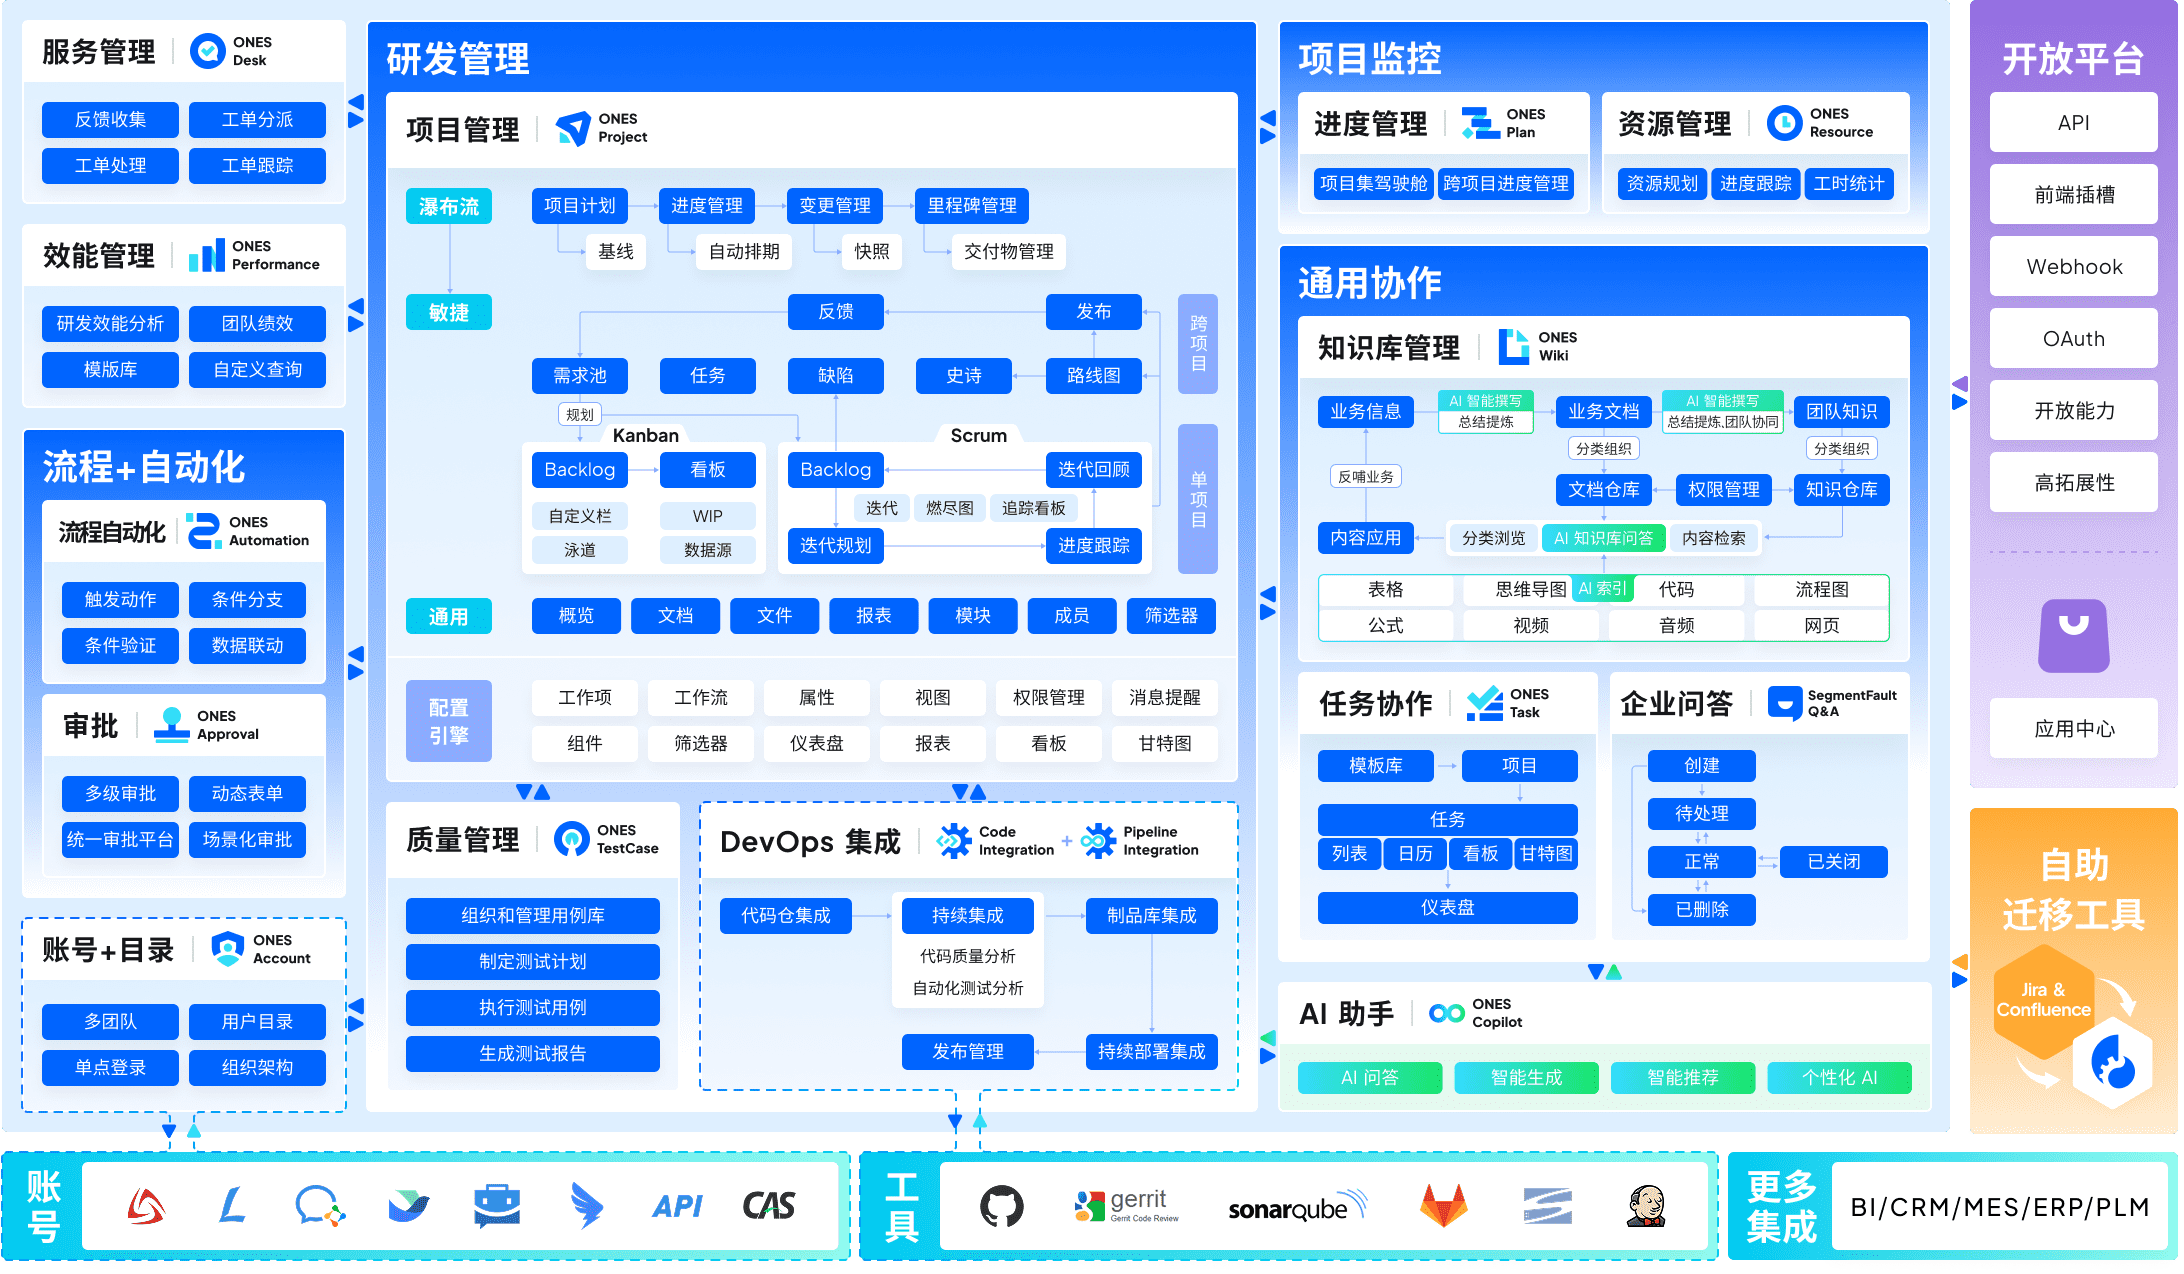
ONES 作为企业级研发管理平台,其知识库模块并非独立存在,而是嵌入在项目管理、需求管理、测试管理、流水线与代码管理的完整链路之中。这一架构设计的核心价值在于消除工具割裂:接口文档可直接关联需求单与代码提交记录,故障复盘可回溯至对应的发布流水线,知识沉淀与研发活动形成闭环而非孤岛。面向中大型组织,ONES 支持复杂流程配置、细粒度权限模型与跨团队协作治理,并内置研发效能度量体系,支持以数据驱动交付质量与效率的持续改进。对于已将研发管理一体化作为基建目标的团队,ONES 的知识库能力是其整体方案的有机组成,而非额外附加的文档工具。
Confluence
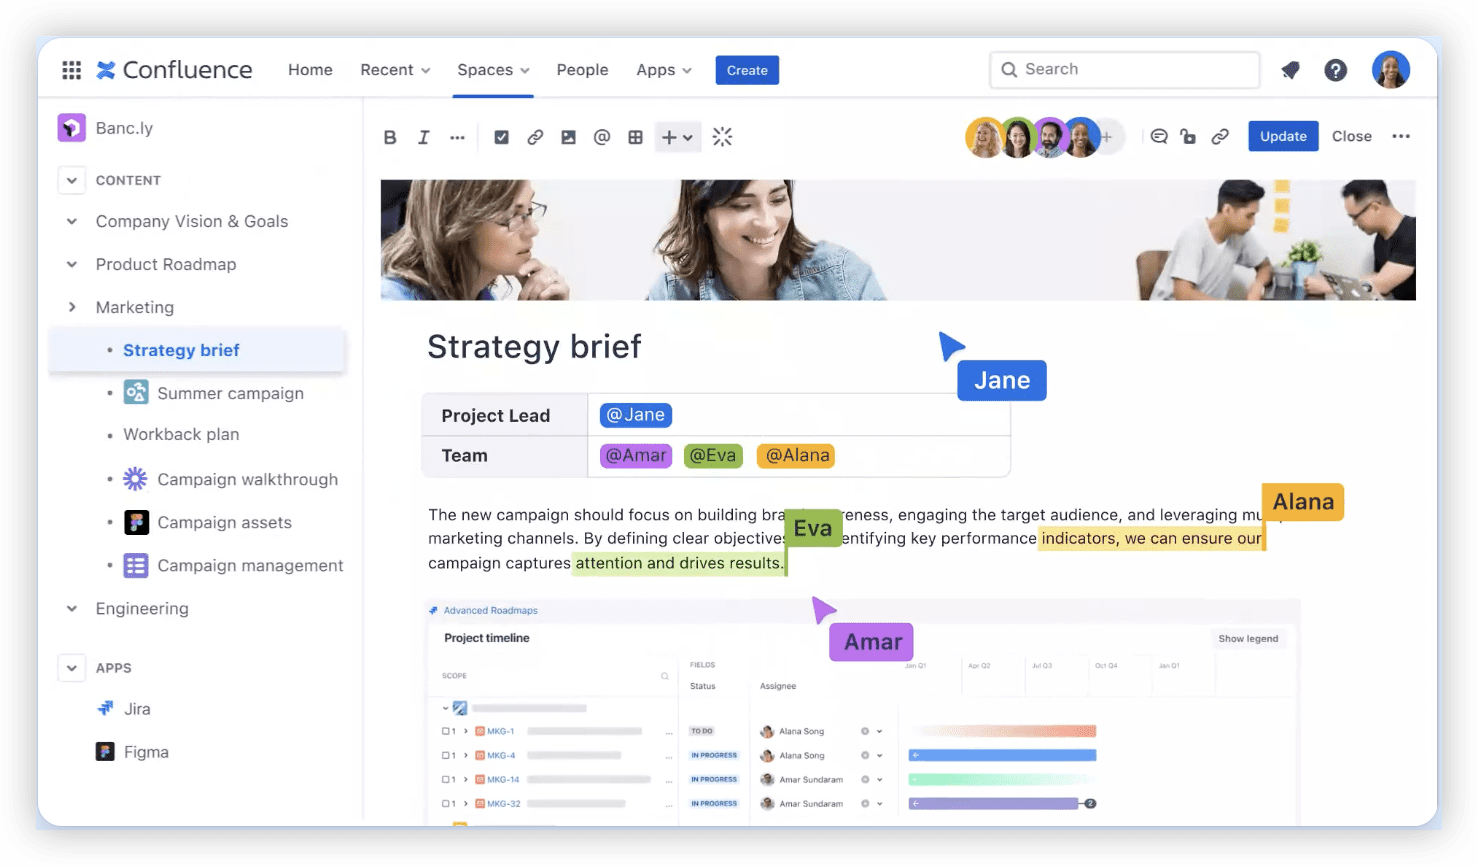
权限体系成熟、页面结构清晰、与 Jira 深度打通,使其成为中大型企业的常见默认选项。但自建版对硬件与运维要求不低,编辑器代码块体验中规中矩,Markdown 支持不够流畅。10 人左右团队使用会有明显的笨重感。
Notion
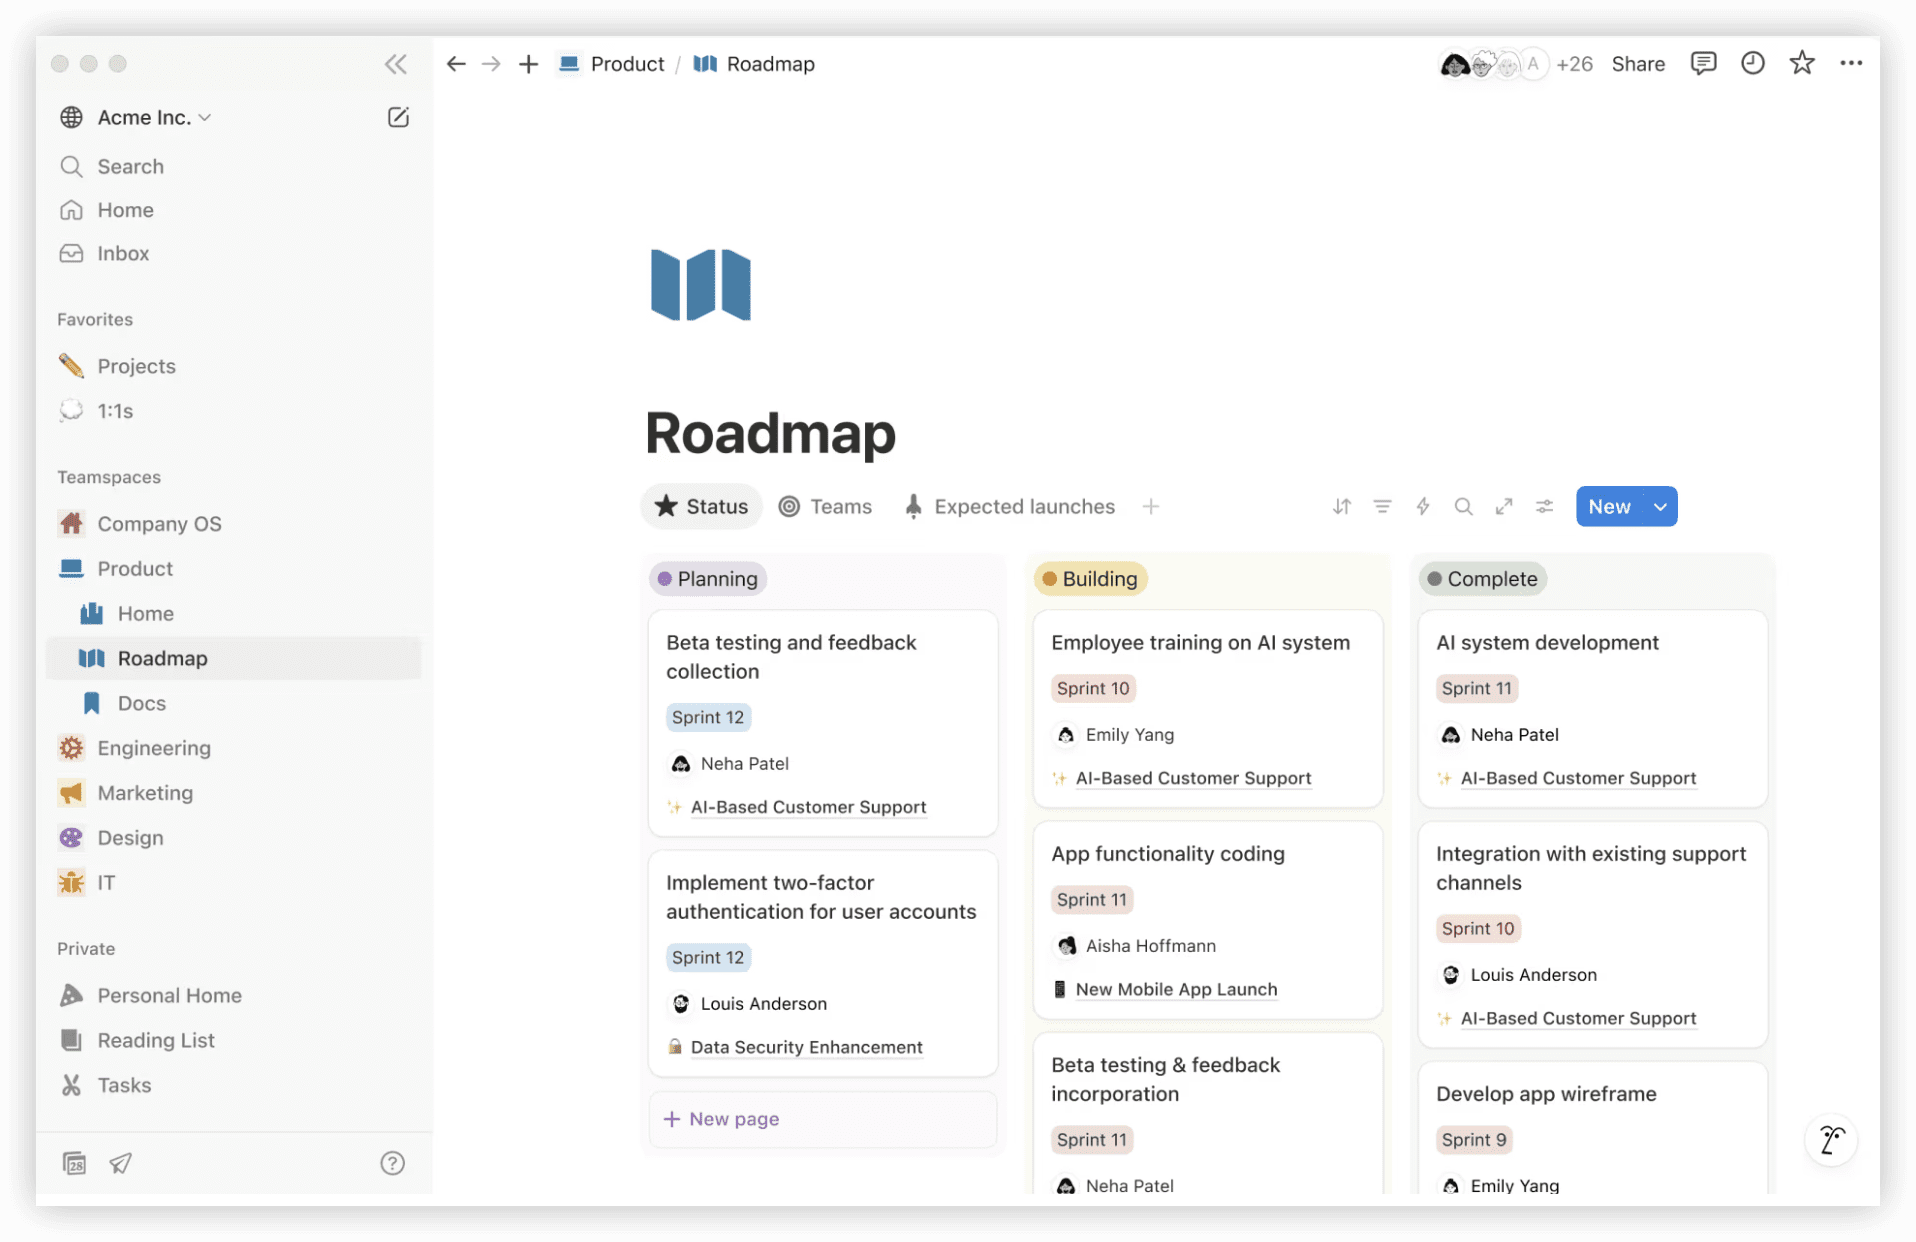
排版灵活性极高,但无法真正私有部署,且对结构化技术文档的支持弱于预期。API 表、序列图、代码片段混排后常形成不可检索的内容块。更适合产品需求池、团队周报等泛内容场景,而非研发知识库的单一载体。
Outline
开源项目,界面风格接近 Notion 但体量轻量许多。原生支持 Markdown、代码块与协同编辑,专为自托管设计,Docker Compose 即可拉起。权限模型与文档嵌套逻辑精准匹配团队维基需求,开发者体验出色。短板在于插件市场有限,无内置工作流管理能力。
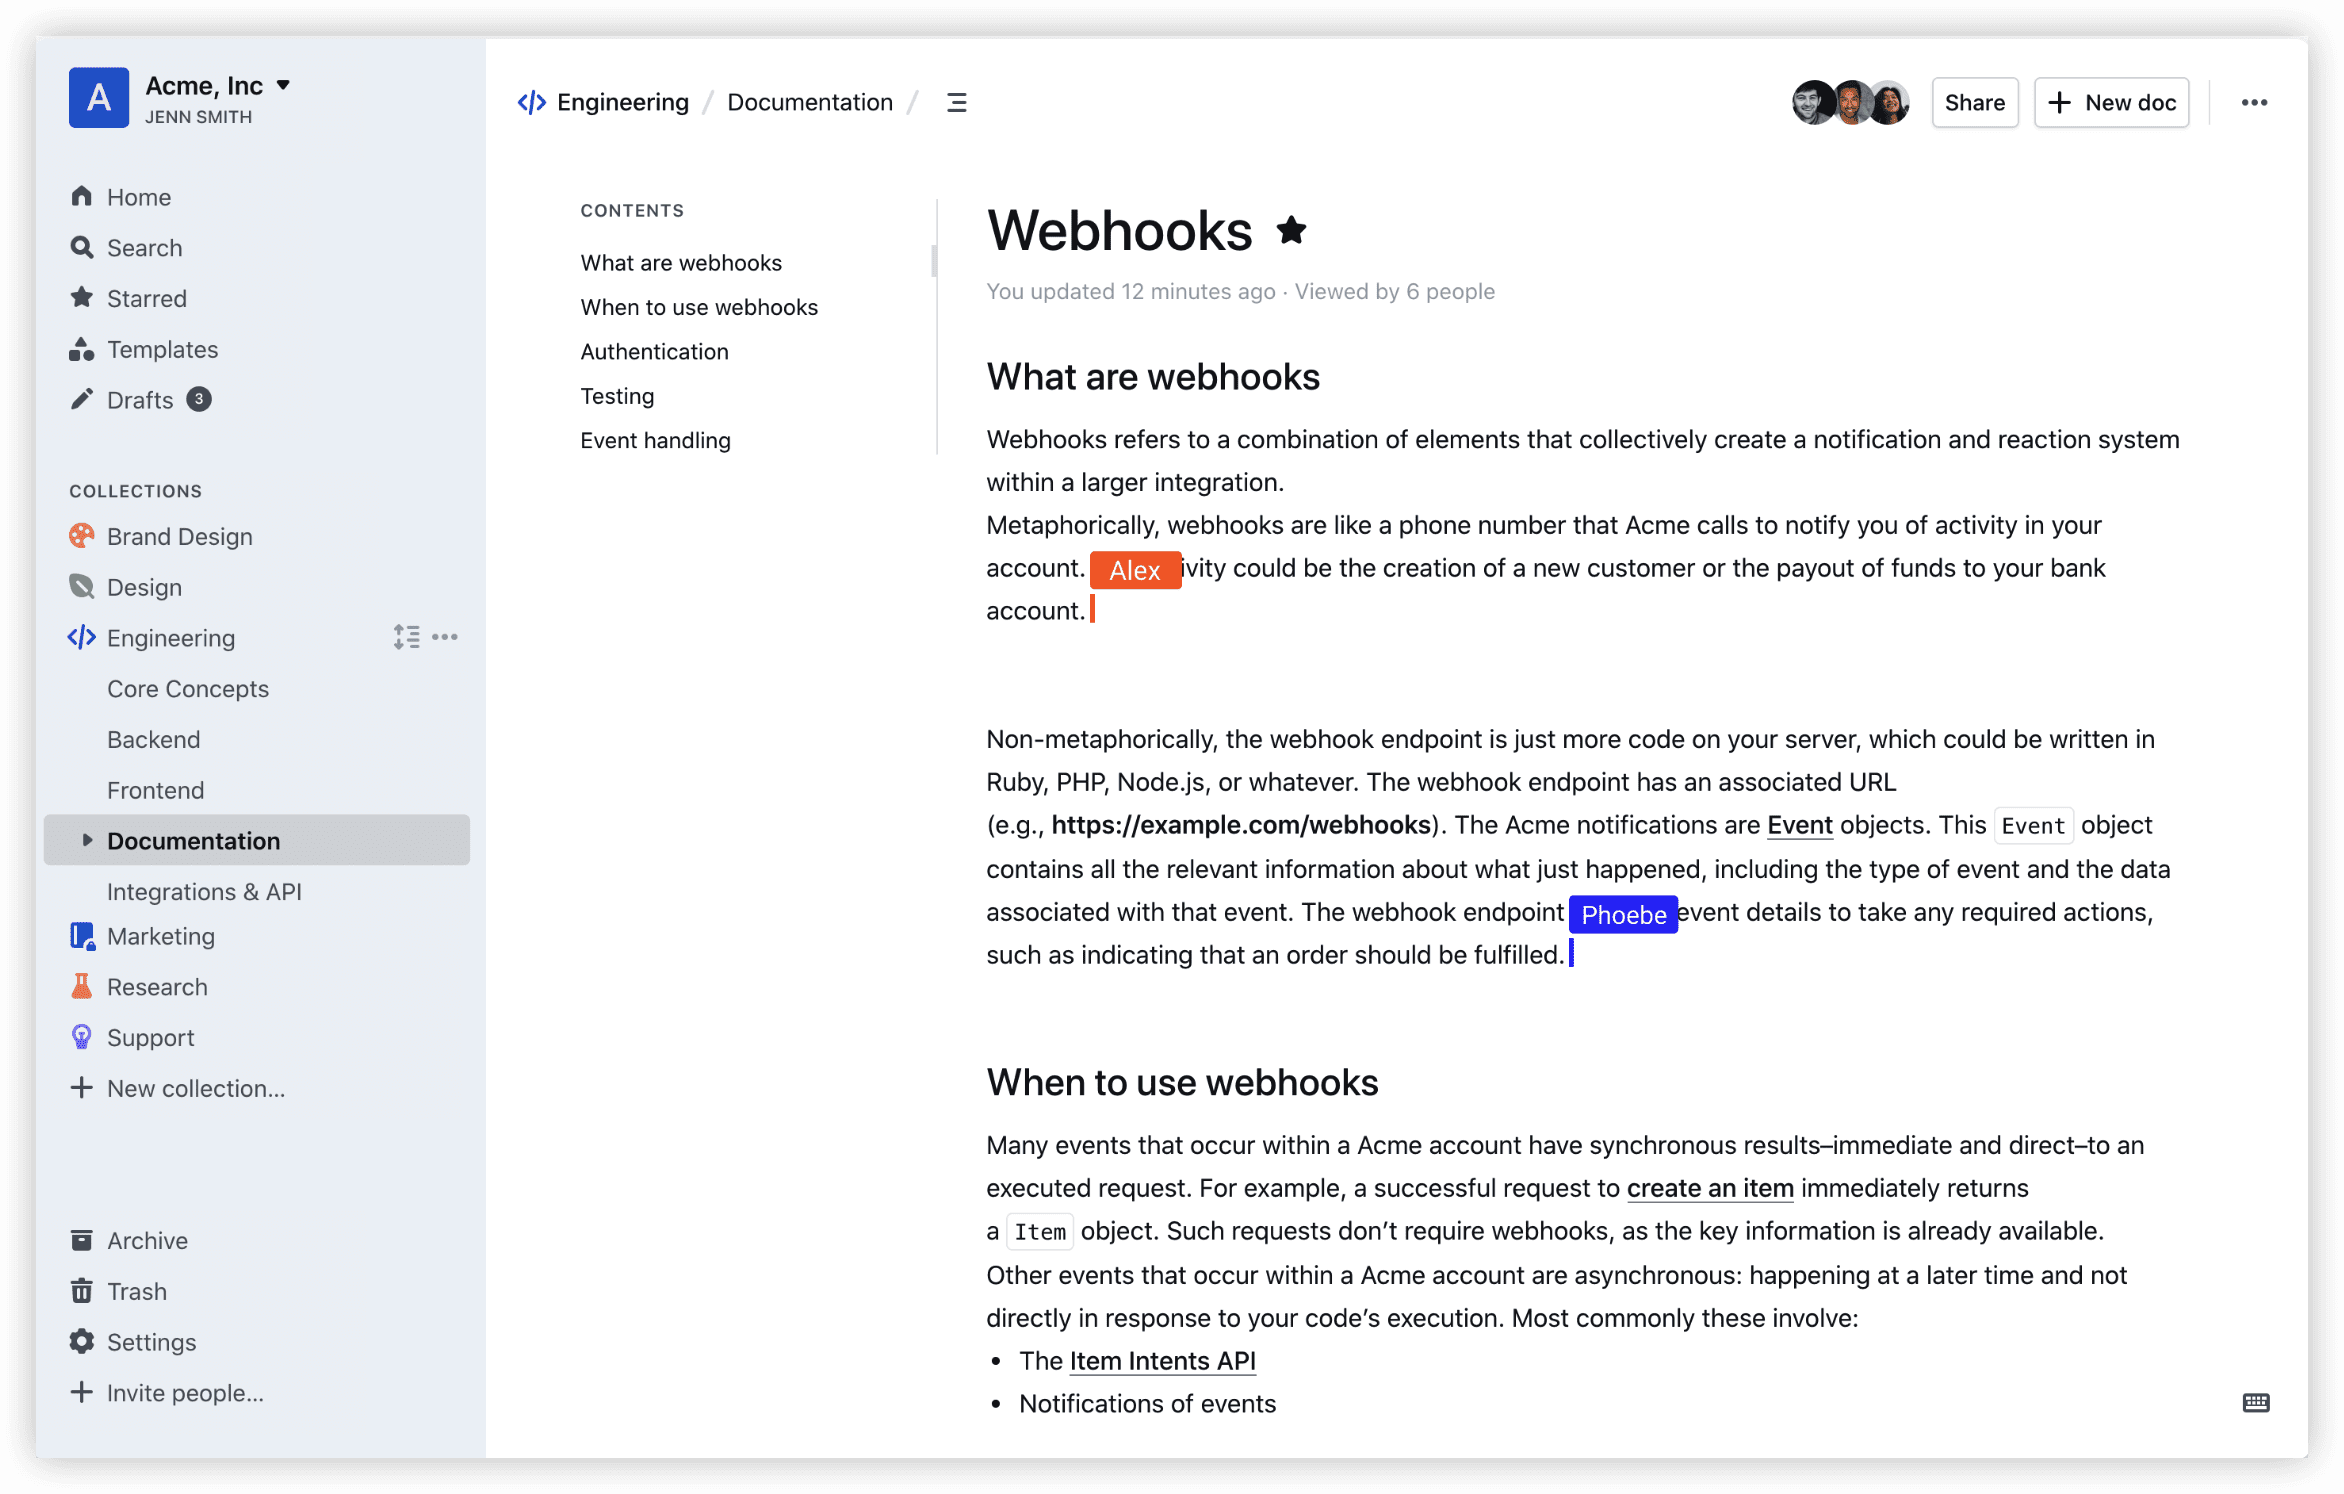
Wiki.js
Node.js 应用资源占用低,与 Git 仓库可紧密集成。但单人维护的开源节奏导致插件体系不丰富,复杂权限与内容模型约束下手段有限。适合有基础设施工程师长期维护的场景。

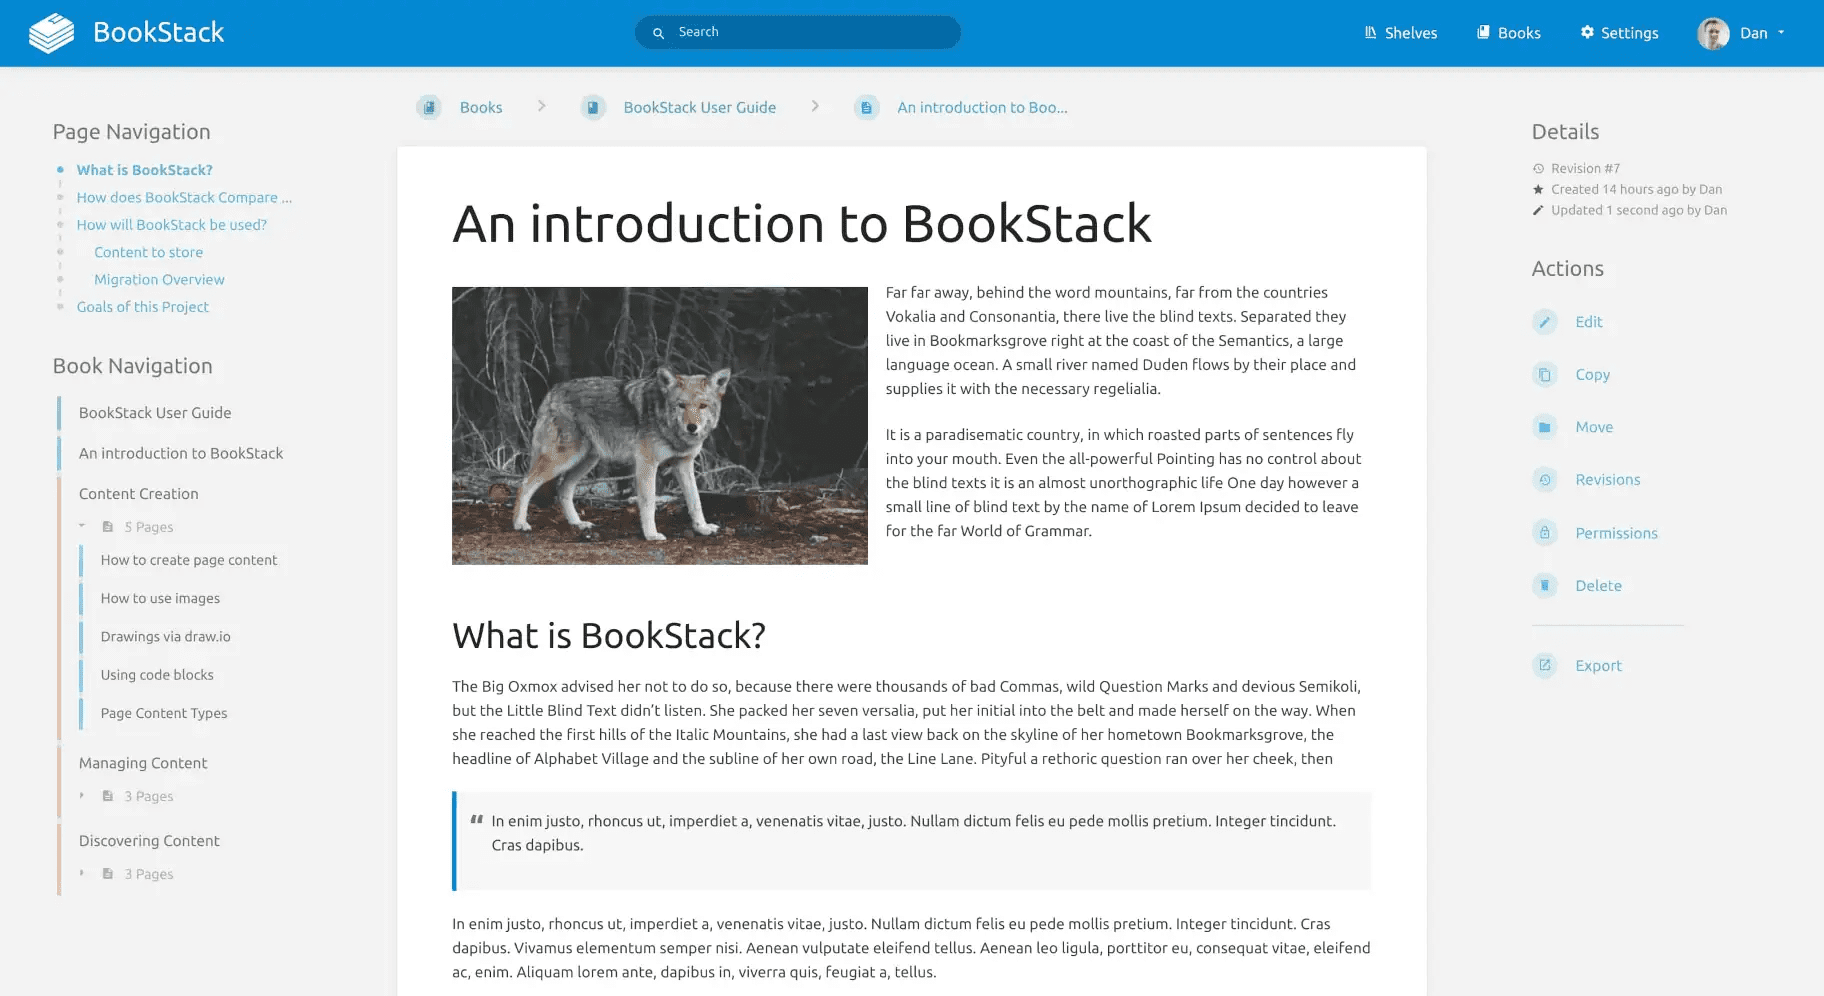
BookStack
“图书-章节-页面”三层结构对重视文档规范秩序的团队友好。编辑体验相对传统,代码块与多人协同一般。更适合运维手册、规范合集等强结构内容,而非大规模研发文档。
Docusaurus
严格而言是静态站点生成器而非知识库系统,但将文档以 Markdown 置于代码仓库、通过 Git 流程管理版本与 PR Review 后发布,这一模式对开源项目、SDK 文档、面向工程师的产品说明极具价值。代价是无在线编辑能力,对非技术成员门槛较高。
AI 原生知识库平台
| 工具 | 部署模式 | 核心能力 | 研发适配度 | 上手门槛 | 适用边界 |
|---|---|---|---|---|---|
| Dify | 自建/云 | 完整 RAG 流水线 + 工作流编排 + 模型管理 | 高,可深度定制 | 中等 | 需针对性调优默认参数 |
Dify
定位为 LLM 应用开发平台,知识库仅是其中一个模块。能力边界远超单一知识库软件:可将团队知识库构建为内部 AI 助手,挂接知识库、接入工作流、分发权限、调度多模型供应商,甚至发布为带对话上下文的应用。对于希望构建内部 AI 问答机器人的研发团队,数据接入、检索增强、模型调度、应用发布的全流程可视化,相比纯代码开发 RAG 服务大幅降低了重复工作量。
私有部署关键工程决策
存储层选型
知识库底层通常包含三类存储组件:对象存储(原始文档与图片)、结构化数据库(页面元数据、权限、版本)、检索或向量数据库(全文索引与文档向量)。
- 文档附件:MinIO 是多数自托管工具的标准搭配,需注意桶备份与生命周期管理;内网环境也可直接挂载本地磁盘路径
- 元数据库:PostgreSQL 是通用答案,JSONB 支持、全文检索能力与扩展生态更适合文档型系统
- 向量存储:10 万片段以内优先 PostgreSQL + pgvector,备份方案统一;大体量或多团队共享场景再考虑 Milvus 等专用向量库
模型层策略
嵌入模型与对话模型需分开考量。中文内容优先 BAAI/bge-m3 或 bge-large-zh-v1.5,英文可用 nomic-embed-text 或 OpenAI text-embedding-3-small。嵌入模型选定后不宜更换,否则需全库向量重建。对话模型私有部署常用 Ollama + 量化版本,如 Qwen2.5-7B-Instruct 的 q4_K_M 版本可在 16G 内存机器运行。若允许 API 网关方案,检索召回本地进行、仅生成阶段调用云端大模型,是隐私、质量与成本的较优平衡。
模型回答质量不佳时,排查顺序应为:文档切块粒度 → 召回策略 → 对话模型。将问题归因于”模型不够聪明”通常是方向性错误。
文档解析与分块
文档解析环节常见陷阱:Word 目录与批注被一并灌入、PDF 扫描件未启用 OCR、表格被碎块化处理。上传前建议统一转为 Markdown 或纯文本,去除页眉页脚与无关封面。
分块策略参考:Markdown 按标题与代码块结构切分;纯文本设置单块 500-800 token、重叠窗口 100 token;API 定义与命令脚本等对精确度要求极高的内容可单独切小。同时建议启用混合检索(BM25 + 向量相似度)与 rerank 模型(如 BGE-reranker),对专业术语命中与结果排序有明显提升。
权限、备份与升级
- 权限:优先对接现有 SSO/OIDC/LDAP,至少区分”核心维护者”与”普通阅读者”两级
- 备份:PostgreSQL 每日 pg_dump,对象存储增量备份,不依赖单一云厂商快照
- 升级:生产环境不追最新版本,新 minor 版本发布一至两周后再评估;确认 Breaking Change 与数据库迁移兼容性;配置修改通过环境变量或挂载文件实现,避免容器内手工修改
部署规模演进
多数百人团队单机部署完全够用:8C16G 服务器,系统盘放 Docker 数据,额外数据盘存储 PostgreSQL 与对象存储。出现以下信号再考虑 Kubernetes:知识库成为面向全公司的高频服务需多副本伸缩;与其他内部应用统一编排管理;单机性能确已达瓶颈。建议先用 Docker Compose 运行半年,验证真正成为日常依赖后再迁移。
按团队规模的选型路径
10 人以下团队
核心目标是信息集中与低维护成本。有私有部署需求且团队熟悉 Docker 时,Outline 是简洁选择;已深度使用办公套件云文档则直接沿用,避免额外系统。AI 能力不值得专门建设,偶尔需要可用轻量桌面工具对接本地模型。
20-50 人成长型团队
工程化文档为主的核心内容建议迁入 Git 仓库,以 Docusaurus 生成统一文档站;同步引入 Dify 搭建内部 AI 问答助手,处理高频重复查询。私有部署单台 16G 服务器跑 Docker Compose 即可,无需追求高可用。
50 人以上或合规要求明确的团队
知识库涉及审计、权限分级与数据合规。Confluence Data Center 的细粒度权限与审计日志具备优势;若规避商业授权绑定,Outline 配合 OIDC 与定期备份亦可支撑。AI 能力通过 Dify 实现时,建议设计 API 网关策略确保原始文档不出内网。此阶段核心价值在于权限模型与备份恢复的可操作性。
常见陷阱与避坑建议
- 只建不养:知识库是活系统,需明确责任人,每季度内容清理、半年健康度 Review
- 导入不校验:迁移后安排抽查式验收,排查排版错乱、图片丢失、附件失效
- 忽视搜索词习惯差异:新人搜索用语与文档标题常不一致,需通过同义词映射或混合召回机制容忍语义差异
- 对 AI 能力期望过高:RAG 效果依赖解析、分块、检索、重排的持续调优,需真实提问回归测试,非零维护插件
落地建议:先验证再迁移
正式决策前,选取不超过 5 人的小组,用倾向方案搭建最小可用实例,投入真实文档使用一周。观察核心信号:是否有人愿意持续写入新文档?检索能否直达目标?维护者是否被日常操作消耗耐心?若信号负面,功能清单再完善也难以在团队存活。
知识库建设约七成是组织问题,三成是技术问题。工具降低写作与检索成本,但无法替代知识分享文化与内容治理机制。选定团队用起来不别扭、支持私有部署、关键场景 AI 能辅助的工具后,优先推动核心技朧骨干常态化写与搜,形成种子效应。上线当天即搭建与代码仓库联动的自动文档导入流程,让 README 与接口定义半自动同步,这一习惯将使知识库长期保持活力。
常见问题
研发团队是否必须选择私有部署?
并非必须。15 人以下无合规强需求的团队,托管服务更务实。私有部署的决策应基于系统集成需求、数据合规约束与运维能力储备综合判断。
AI 知识库与传统知识库能否共存?
可以且建议如此。传统知识库作为权威内容源持续维护,AI 知识库平台对接其内容提供问答能力,形成”人写机器答”的分层架构。
如何评估知识库迁移的合适时机?
当出现以下现象时建议认真考虑:文档检索平均需要打开超过三个系统;新人入职文档分散且版本混乱;关键信息依赖特定人员口头传递而非书面沉淀。
嵌入模型选择后能否更换?
技术上可以,但需全库向量重建,期间检索质量不稳定。建议初期充分测试后选定,中长期保持稳定。