构建高效的研发知识管理体系,选对工具是第一步。本文将系统梳理8款2026年值得关注的知识库与研发管理工具,覆盖从个人知识沉淀到企业级智能检索的完整场景:
- ONES — 企业级研发管理一体化平台

- Obsidian — 本地优先的个人知识网络
- Logseq — 开源大纲式双链笔记
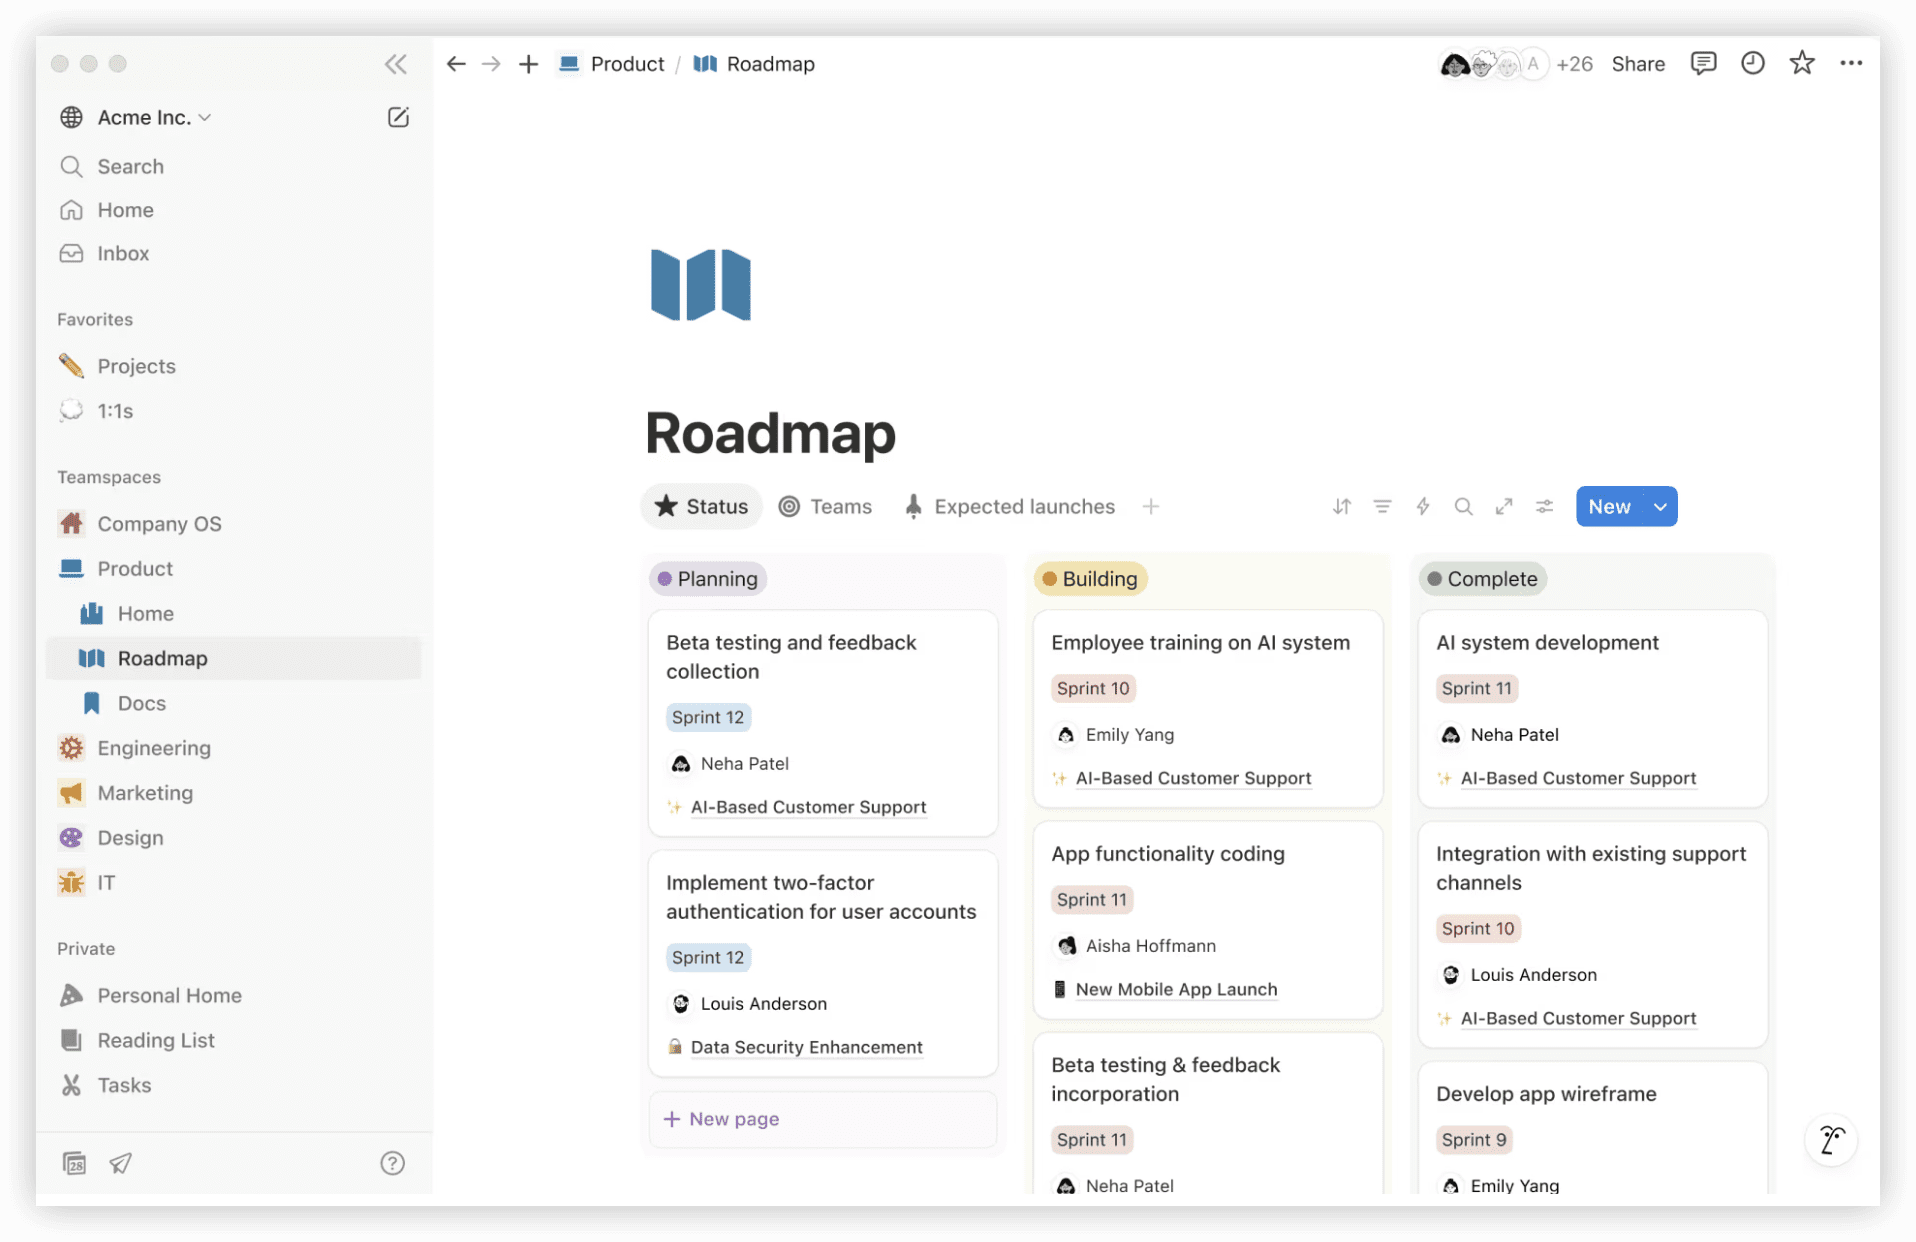
- Notion — 模块化团队协作中枢
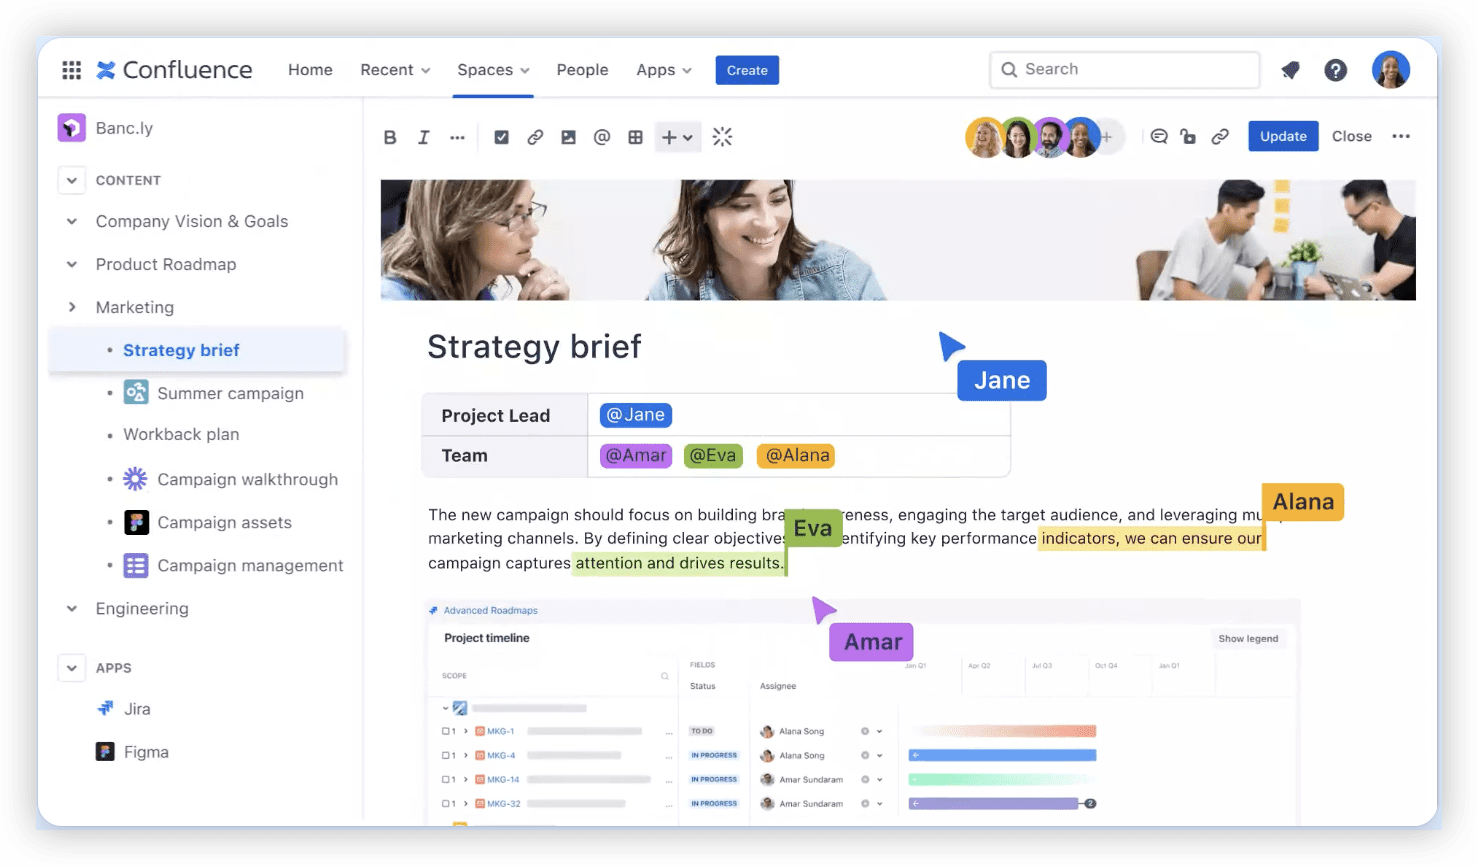
- Confluence — 中大型研发组织Wiki标杆
- Mem0 — 低延迟AI记忆层基础设施
- Dify — 可视化LLM应用编排平台
- RAGFlow — 深度文档解析RAG引擎
选型前需厘清一个核心前提:知识库产品已分化为多条技术路线,跨路线直接比较往往失真。本文先按场景划分赛道,再在赛道内部进行硬指标对比,最终给出可落地的决策路径。
一、赛道全景:四类知识管理范式
| 赛道 | 核心诉求 | 典型用户 | 代表方向 |
|---|---|---|---|
| 个人PKM | 本地存储、双向链接、长期知识复利 | 研究者、独立开发者 | Obsidian、Logseq |
| 团队协作文档 | 结构化Wiki、权限治理、生态集成 | 企业部门、项目团队 | Notion、Confluence |
| AI记忆层 | Agent跨会话状态持久化 | AI应用开发者 | Mem0、Zep |
| 企业RAG框架 | 文档→智能问答/推理 pipeline | 技术团队、中台部门 | Dify、RAGFlow |
前两类解决”人如何记住知识”,后两类解决”AI如何检索与运用知识”——范式差异决定了选型逻辑的根本不同。
二、企业研发管理赛道:ONES 深度解析
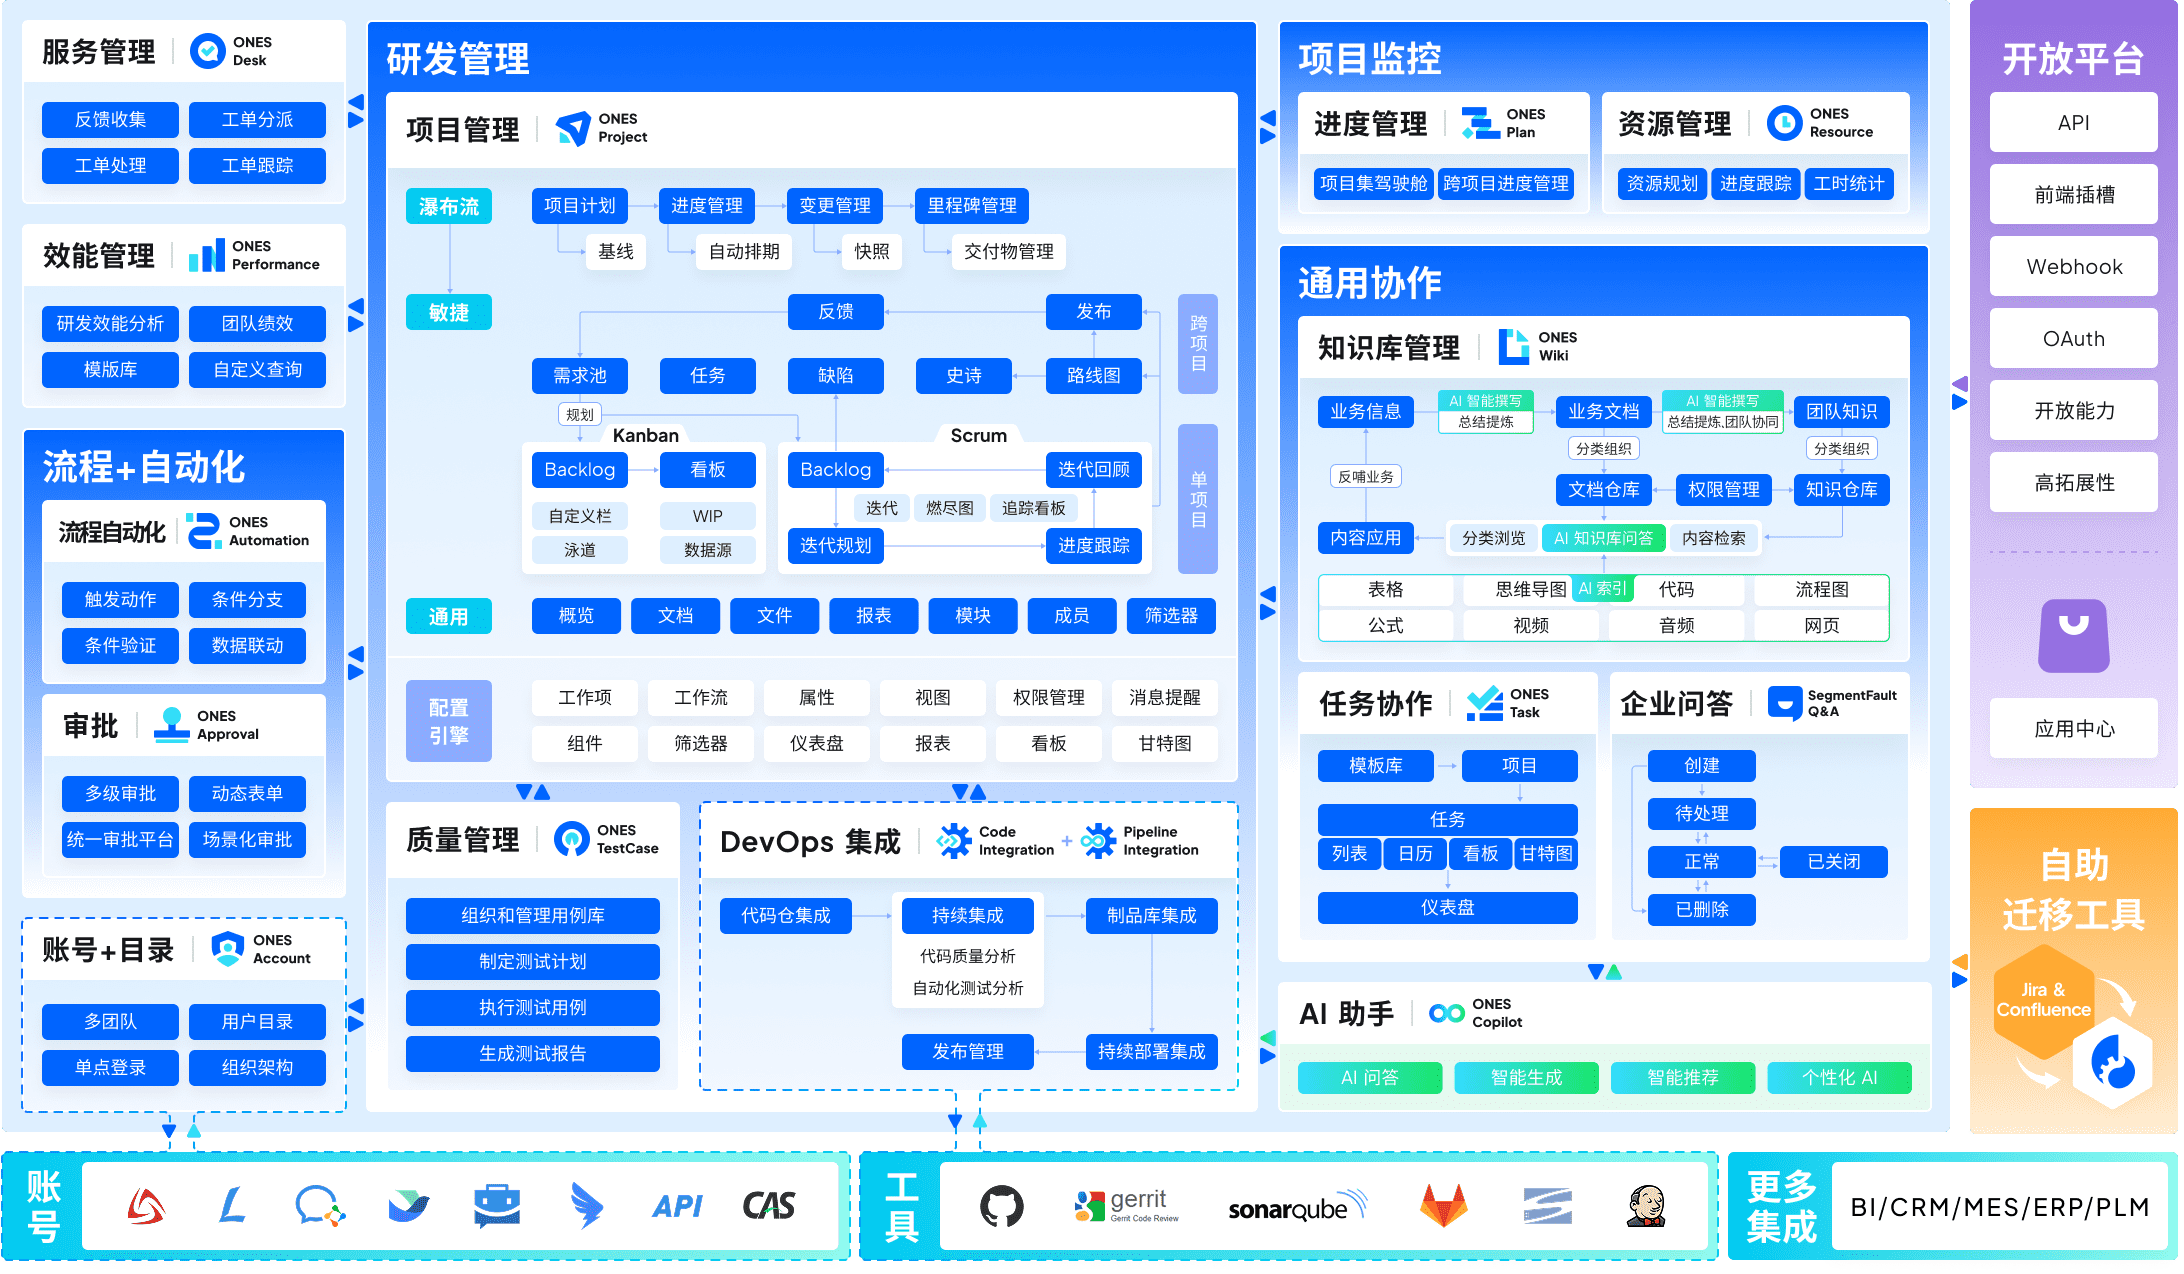
中大型技术组织面临的核心矛盾,在于工具链碎片化导致的数据孤岛与流程断点。ONES 作为企业级研发管理平台,其设计逻辑围绕”一体化治理”展开:
2.1 核心能力架构
全链路覆盖:从需求管理、项目跟踪、知识库沉淀,到测试用例、CI/CD流水线、代码仓库,形成研发活动的闭环数据流。这种集成度避免了 Jira + Confluence + 独立测试工具 + 自建流水线的拼接成本。
组织级复杂度支撑:支持多层级项目模板、细粒度权限矩阵、跨部门资源协调视图。对于百人以上研发团队,流程配置的灵活性直接决定工具能否落地而非被绕过。
效能度量体系:内置交付周期、缺陷逃逸率、需求吞吐量等关键指标,支持从结果数据反推流程瓶颈。区别于单纯的项目进度可视化,其强调”用数据驱动改进”而非”用数据考核个体”。
2.2 适用边界
ONES 的优势场景明确:需要统一研发数字底座的中大型技术组织,尤其是已完成或正在进行研发规范化转型的企业。对于十人以下的轻量团队,全功能套件的学习成本可能高于收益;对于非研发主导的业务部门,协作文档类产品更为贴合。
三、个人PKM赛道:Obsidian 与 Logseq 对比
3.1 产品定位差异
| 维度 | Obsidian | Logseq |
|---|---|---|
| 数据主权 | 本地Markdown,商业授权 | AGPL-3.0开源,完全本地 |
| 信息组织 | 双向链接+图谱+插件扩展 | 大纲层级+块引用+日记流 |
| 生态繁荣度 | 社区插件超2000款 | 社区规模中等,增长稳健 |
| 协作能力 | 依赖第三方同步方案 | 原生支持Git同步 |
3.2 选型建议
重视视觉化知识图谱与丰富插件生态,且接受核心闭源——选 Obsidian。偏好开源可控、大纲式思维、开发者友好工作流——选 Logseq。二者均非”开箱即用”型产品,需要投入时间建立个人知识管理规范。
四、团队协作文档赛道:Notion 与 Confluence
4.1 生态锁定效应
该赛道选型的一条隐性规则:与现有办公生态的绑定强度往往优先于功能对比。已深度使用 Microsoft 365 的组织,SharePoint 的合规与权限体系难以绕过;采用 Atlassian 全家桶的研发团队,Confluence 与 Jira 的联动价值显著;追求灵活数据库与轻量自动化的分散型团队,Notion 的块编辑更具吸引力。
4.2 能力对照
| 能力 | Notion | Confluence |
|---|---|---|
| 内容结构化 | 数据库+视图灵活 | 页面树+宏组件稳定 |
| 研发集成 | API连接,需配置 | Jira原生嵌入,深度绑定 |
| 权限模型 | 页面级+数据库级 | 空间级+页面级+继承规则 |
| 私有化部署 | 企业版有限支持 | Data Center方案成熟 |
| AI能力 | Notion AI内置 | Atlassian Intelligence推进中 |
Notion 适合追求”一个工具覆盖多场景”的敏捷团队;Confluence 适合已有 Atlassian 生态、重视企业级治理的中大型研发组织。
五、AI记忆层赛道:Mem0 的技术定位
当对话式AI需要”记住”用户偏好、历史上下文、动态事实时,传统上下文窗口方案面临长度限制与成本瓶颈。记忆层产品专门解决这一”有状态Agent”基础设施问题。
5.1 Mem0 核心特征
接入极简:三行代码即可完成集成,框架无关设计使其不绑定特定LLM或Agent框架。
多级记忆架构:区分用户级、会话级、Agent级记忆,支持语义检索与关键词检索混合召回。
部署弹性:提供托管云服务与自托管选项,后者满足数据驻留合规要求。
延迟表现:P95 召回延迟约200毫秒,适用于实时交互场景。
5.2 竞品速览
Zep 在时序推理(处理”事实随时间变化”)与企业合规认证(SOC2/HIPAA)方面领先,适合医疗、金融等强监管领域。Letta 赋予Agent自主编辑记忆块的能力,代价是运维复杂度与Token开销显著上升。LangMem 深度集成 LangGraph 生态,支持程序级记忆改写,但延迟表现不适合高并发交互场景。
六、企业RAG框架赛道:Dify 与 RAGFlow
将非结构化文档转化为可问答、可推理的知识库,是2026年企业AI落地的核心场景之一。该赛道产品差异体现在”编排广度”与”解析深度”两个维度。
6.1 Dify:广度优先的LLM应用平台
以154K+ GitHub Stars 的社区规模领先,提供可视化工作流编排、知识库Pipeline、多模型接入、插件市场与运营观测面板。其设计目标是”从原型到生产不重构”——同一平台覆盖实验调试与线上运维。企业版通过 SOC2 Type II 与 ISO 27001 认证,降低安全合规门槛。
6.2 RAGFlow:深度文档解析专家
核心壁垒在于 DeepDoc 引擎:结合 OCR、表格结构识别、文档版面分析三类视觉模型,对复杂PDF、扫描件、多栏排版的还原精度显著高于通用方案。0.25版本引入Agent沙盒与用户级记忆隔离,向”解析+推理”一体化演进。
6.3 选型取舍
| 场景特征 | 推荐选择 |
|---|---|
| 快速验证RAG概念,需丰富集成生态 | Dify |
| 合同、财报、论文等复杂版式文档 | RAGFlow |
| 已深度使用 LangChain/LangGraph | Dify 或原生LangMem |
| 全离线环境、跨语言需求、注意协议风险 | QAnything(AGPL-3.0需评估) |
七、综合决策框架
7.1 首层分流:明确知识管理主体
问题A:知识的服务对象是人还是AI?
- 人 → 进入个人PKM或团队协作文档赛道
- AI → 继续判断记忆层或RAG框架
问题B:AI需要”跨会话记住状态”还是”从文档中检索答案”?
- 有状态Agent → 记忆层赛道(Mem0/Zep/Letta)
- 文档问答/推理 → RAG框架赛道(Dify/RAGFlow)
7.2 典型场景匹配
| 组织场景 | 推荐方案 |
|---|---|
| 中大型研发团队统一管理平台 | ONES |
| 个人研究者长期知识沉淀 | Obsidian 或 Logseq |
| 跨部门敏捷协作与轻量数据库 | Notion |
| 已有Jira生态的研发知识库 | Confluence |
| AI客服/助手需要用户记忆 | Mem0(通用)/ Zep(合规) |
| 企业文档智能问答POC | Dify 或 RAGFlow |
八、关键风险提示
协议合规:AGPL-3.0 类许可证(如 Logseq、QAnything)具有强Copyleft特征,闭源商用需法务评估;MIT/Apache-2.0 类(如 Mem0、Dify、RAGFlow)商用限制较少。
赛道错配成本:将RAG框架用于个人笔记管理、将记忆层用于静态文档检索,均会导致实施效率低下。先定位范式,再比较产品。
动态验证必要性:Stars数量、版本迭代、定价策略变化较快,建议以官方渠道信息为准,并在最终决策前用真实数据集跑通POC,实测召回准确率、响应延迟与Token成本。
九、结论
2026年的知识库选型已非单一产品比拼,而是场景-范式-工具的三层匹配:
- 人的知识管理 → Obsidian/Logseq(个人)或 Notion/Confluence(团队)或 ONES(研发组织一体化)
- AI的状态记忆 → Mem0(快速接入)、Zep(时序合规)、Letta(自主进化)
- AI的文档检索 → Dify(生态广度)、RAGFlow(解析深度)
工具的价值最终取决于与组织现有流程的契合度。建议优先明确自身赛道归属,再缩小范围进行针对性验证,避免在”功能最全”的迷思中过度投入。
常见问题
Q1:ONES 与通用协作文档的核心差异是什么?
ONES 面向研发全生命周期,需求-任务-代码-测试-发布形成数据闭环;通用协作文档侧重内容创作与知识沉淀,缺乏研发特有流程的深度支持。
Q2:小型团队是否需要全套研发管理平台?
十人以下团队建议从轻量工具起步,待流程成熟、协作复杂度上升后再迁移至 ONES 等完整方案,避免过早引入管理 overhead。
Q3:AI记忆层与RAG框架能否互相替代?
不能。记忆层解决Agent”记住对话历史”的问题,RAG解决”从文档库检索答案”的问题,二者常组合使用而非二选一。
Q4:开源产品的商业使用需要注意什么?
重点核查许可证类型:MIT/Apache-2.0 通常允许闭源商用;AGPL-3.0 要求衍生作品同样开源,需根据实际使用方式评估合规风险。
Q5:如何验证RAG方案的实际效果?
准备覆盖真实业务场景的测试数据集,统一评估召回准确率、答案相关性、端到端延迟、单次查询成本四项指标,避免仅依赖官方基准数据。